Serie «Kubernetes en OCI al menor costo» — parte 1. En la parte 0 vimos por qué OCI y cuánto cuesta. Acá está el mapa de todo lo que vamos a construir.
Un cluster de Kubernetes recién creado no sirve para producción: le faltan la forma de recibir tráfico, los certificados, los secretos, una base de datos, mensajería, métricas, logs y una manera reproducible de desplegar. En AWS gran parte de eso lo resolvés contratando servicios gestionados (ALB, ACM, Secrets Manager, RDS, SQS, CloudWatch). En esta serie lo resolvemos dentro del cluster con software open source, que es más barato y portable, a cambio de operarlo vos.
Este post es el mapa. La idea es que, en próximas entregas, cada pieza tenga su propio post de cómo funciona por dentro.
El diagrama#
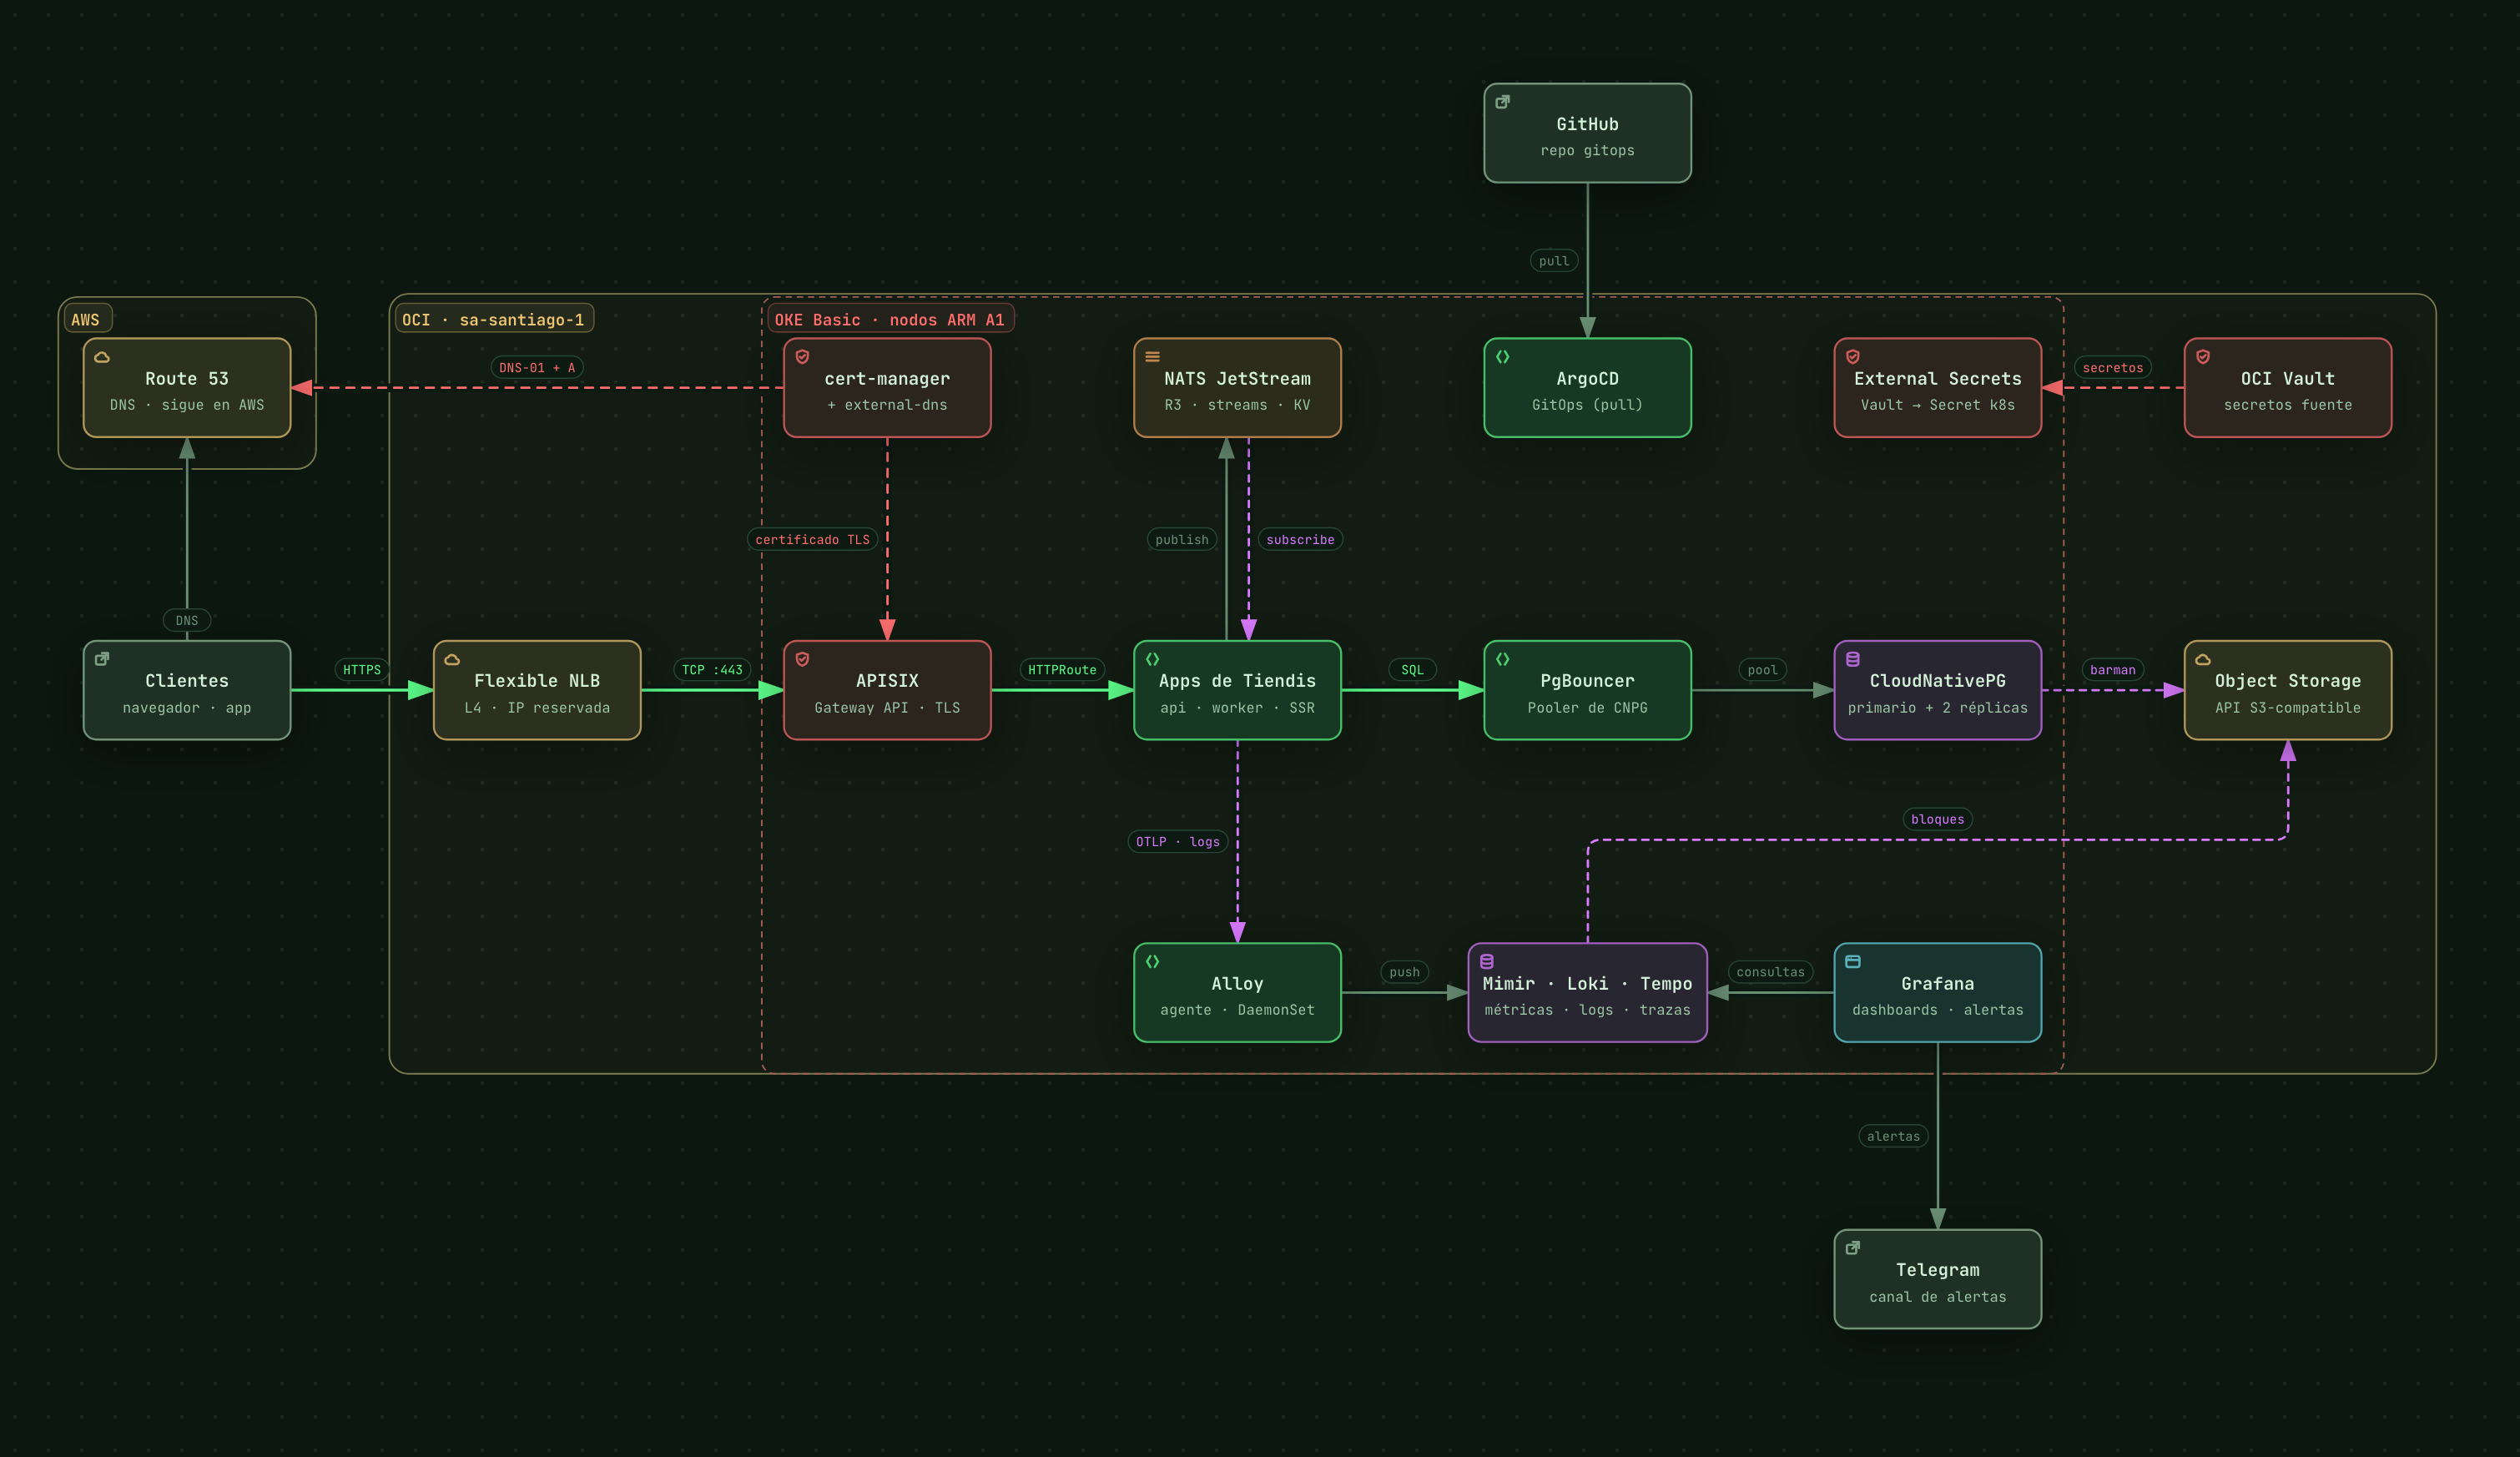
Abrí el diagrama interactivo para recorrerlo pieza por pieza.
Las piezas y su equivalente en AWS#
| Pieza | Para qué | Equivalente en AWS | Diferencia clave |
|---|---|---|---|
| OKE Basic | Control plane de Kubernetes | EKS | Sin costo y sin SLA, contra USD 0,10/h con SLA |
| Node pools A1 + cluster-autoscaler | Nodos ARM que escalan | Managed node groups / Karpenter / Auto Mode | En OKE no hay Karpenter: el autoscaler escala node pools existentes, no elige el tipo de instancia |
| Flexible NLB | Entrada L4 con IP fija | NLB | El de OCI no cobra hora ni tráfico procesado |
| APISIX | Gateway L7: rutas, TLS, rate limit, websockets | ALB + AWS Load Balancer Controller, o API Gateway | Lo operás vos, pero el costo es fijo y no hay precio por request ni por LCU |
| cert-manager | Certificados TLS automáticos | ACM | ACM es gratis pero solo se usa en ALB/NLB/CloudFront. cert-manager deja el certificado como un Secret usable por cualquier pod |
| external-dns | Registros DNS desde los HTTPRoute |
Route 53 + integración del LB Controller | Igual, apuntando a Route 53 desde otra nube |
| NATS JetStream | Mensajería, colas, streams y KV | SNS + SQS, EventBridge, Kinesis, ElastiCache | Un componente en vez de cuatro servicios. Lo operás vos, incluido el quórum |
| CloudNativePG | Postgres con HA, backups y PITR | RDS / Aurora | Backups barman a Object Storage. Lo que RDS te da hecho (parches, failover probado), acá es tu responsabilidad |
| Mimir · Loki · Tempo | Métricas, logs y trazas | CloudWatch Metrics/Logs, X-Ray, Managed Prometheus | Se paga storage barato en vez de ingesta: CloudWatch Logs cobra por GB ingerido |
| Grafana + Alloy + Faro | Dashboards, alertas, agente y RUM | Managed Grafana, CloudWatch Alarms, CloudWatch RUM | Estándares abiertos (OpenTelemetry, PromQL, LogQL) en vez de APIs propietarias |
| ArgoCD | GitOps: el cluster refleja un repo git | Argo CD gestionado (EKS Capabilities), o CodePipeline / CodeDeploy | El de AWS solo despliega a clusters EKS y cobra USD 0,03/h más USD 0,0015/h por Application y por cluster destino: con mis 52 Applications serían ~USD 79/mes. Instalado en el cluster no cobra nada aparte de sus recursos |
| External Secrets + OCI Vault | Secretos de la nube como Secret de k8s |
Secrets Manager + ESO o el Secrets Store CSI Driver | El operador es el mismo. Cambia solo el SecretStore |
| OCIR | Registry de imágenes | ECR | Equivalentes. Ojo con el formato de usuario <namespace>/<usuario> en docker login |
| OCI Object Storage | Backups, chunks de métricas, logs y trazas | S3 | Tiene endpoint S3-compatible, pero no es S3: hay operaciones que no soporta (lo voy a contar en una próxima entrega, con el tfstate) |
Cómo se organiza el código: dos repos#
infra/          # Terraform — lo que vive en la API de OCI
  network.tf      VCN, subnets, gateways, NSG, IPs públicas reservadas
  oke.tf          cluster (BASIC_CLUSTER, FLANNEL_OVERLAY)
  nodepools.tf    pool de apps + pool de CI escalable a 0
  iam.tf          dynamic groups + policies
  vault.tf        vault, key y secretos fuente
  ocir.tf  object_storage.tf  budget.tf

gitops/         # ArgoCD — lo que vive dentro del cluster
  base/           app raíz, AppProjects, ApplicationSets, repos
  runtime/        un dir por componente: values del chart + manifiestos extra
  apps/<producto>/{base,dev,prd}/<servicio>   kustomize base + overlays
La regla es simple: Terraform crea lo que la nube factura; ArgoCD instala lo que corre dentro del cluster. Terraform no instala charts de Helm y ArgoCD no crea recursos de la nube. Hay una sola excepción, el arranque: ArgoCD se instala una única vez a mano, y después se gestiona a sí mismo.
Los cuatro flujos que hay que entender#
1. Un deploy#
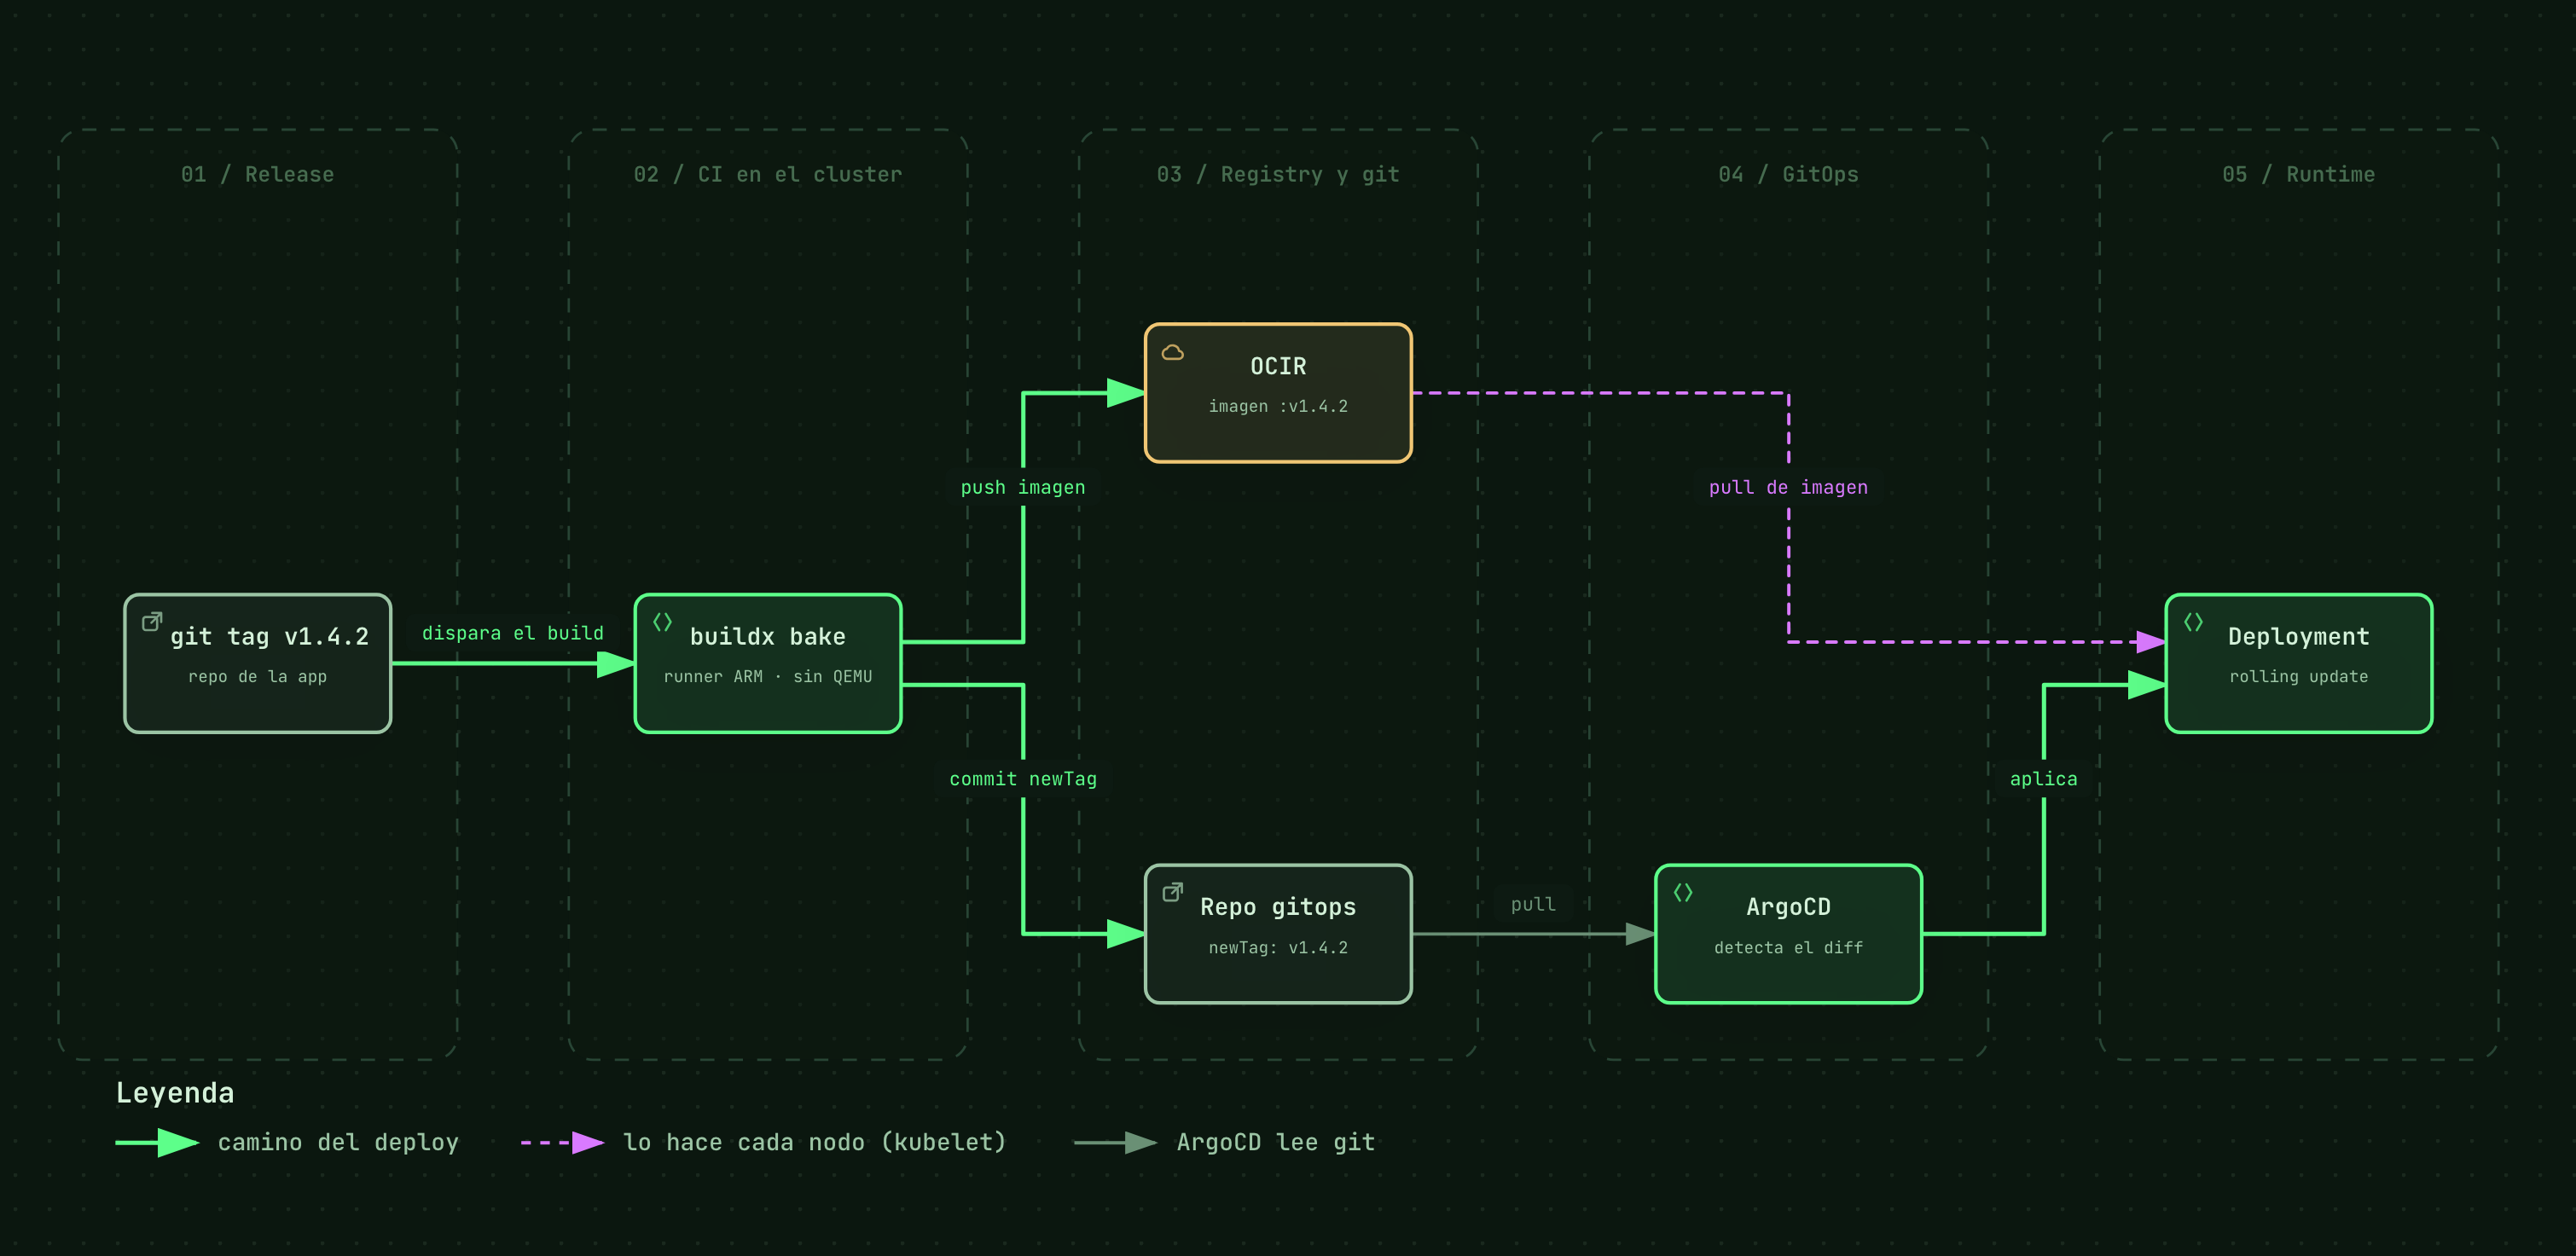
# gitops/apps/tienda/prd/api/kustomization.yaml
images:
  - name: api
    newName: <region>.ocir.io/<namespace>/tienda/api
    newTag: v1.4.2   # ← el deploy es este diff
El runner corre en un node pool ARM que escala de 0 a 2, así que buildear arm64 es nativo
y rápido (emular con QEMU desde un runner x86 multiplica los tiempos). En AWS lo típico es
CodePipeline/CodeBuild empujando a ECR y llamando a kubectl o
CodeDeploy (push). Con GitOps, el estado deseado queda versionado en git y un rollback es
un git revert.
2. Un secreto#
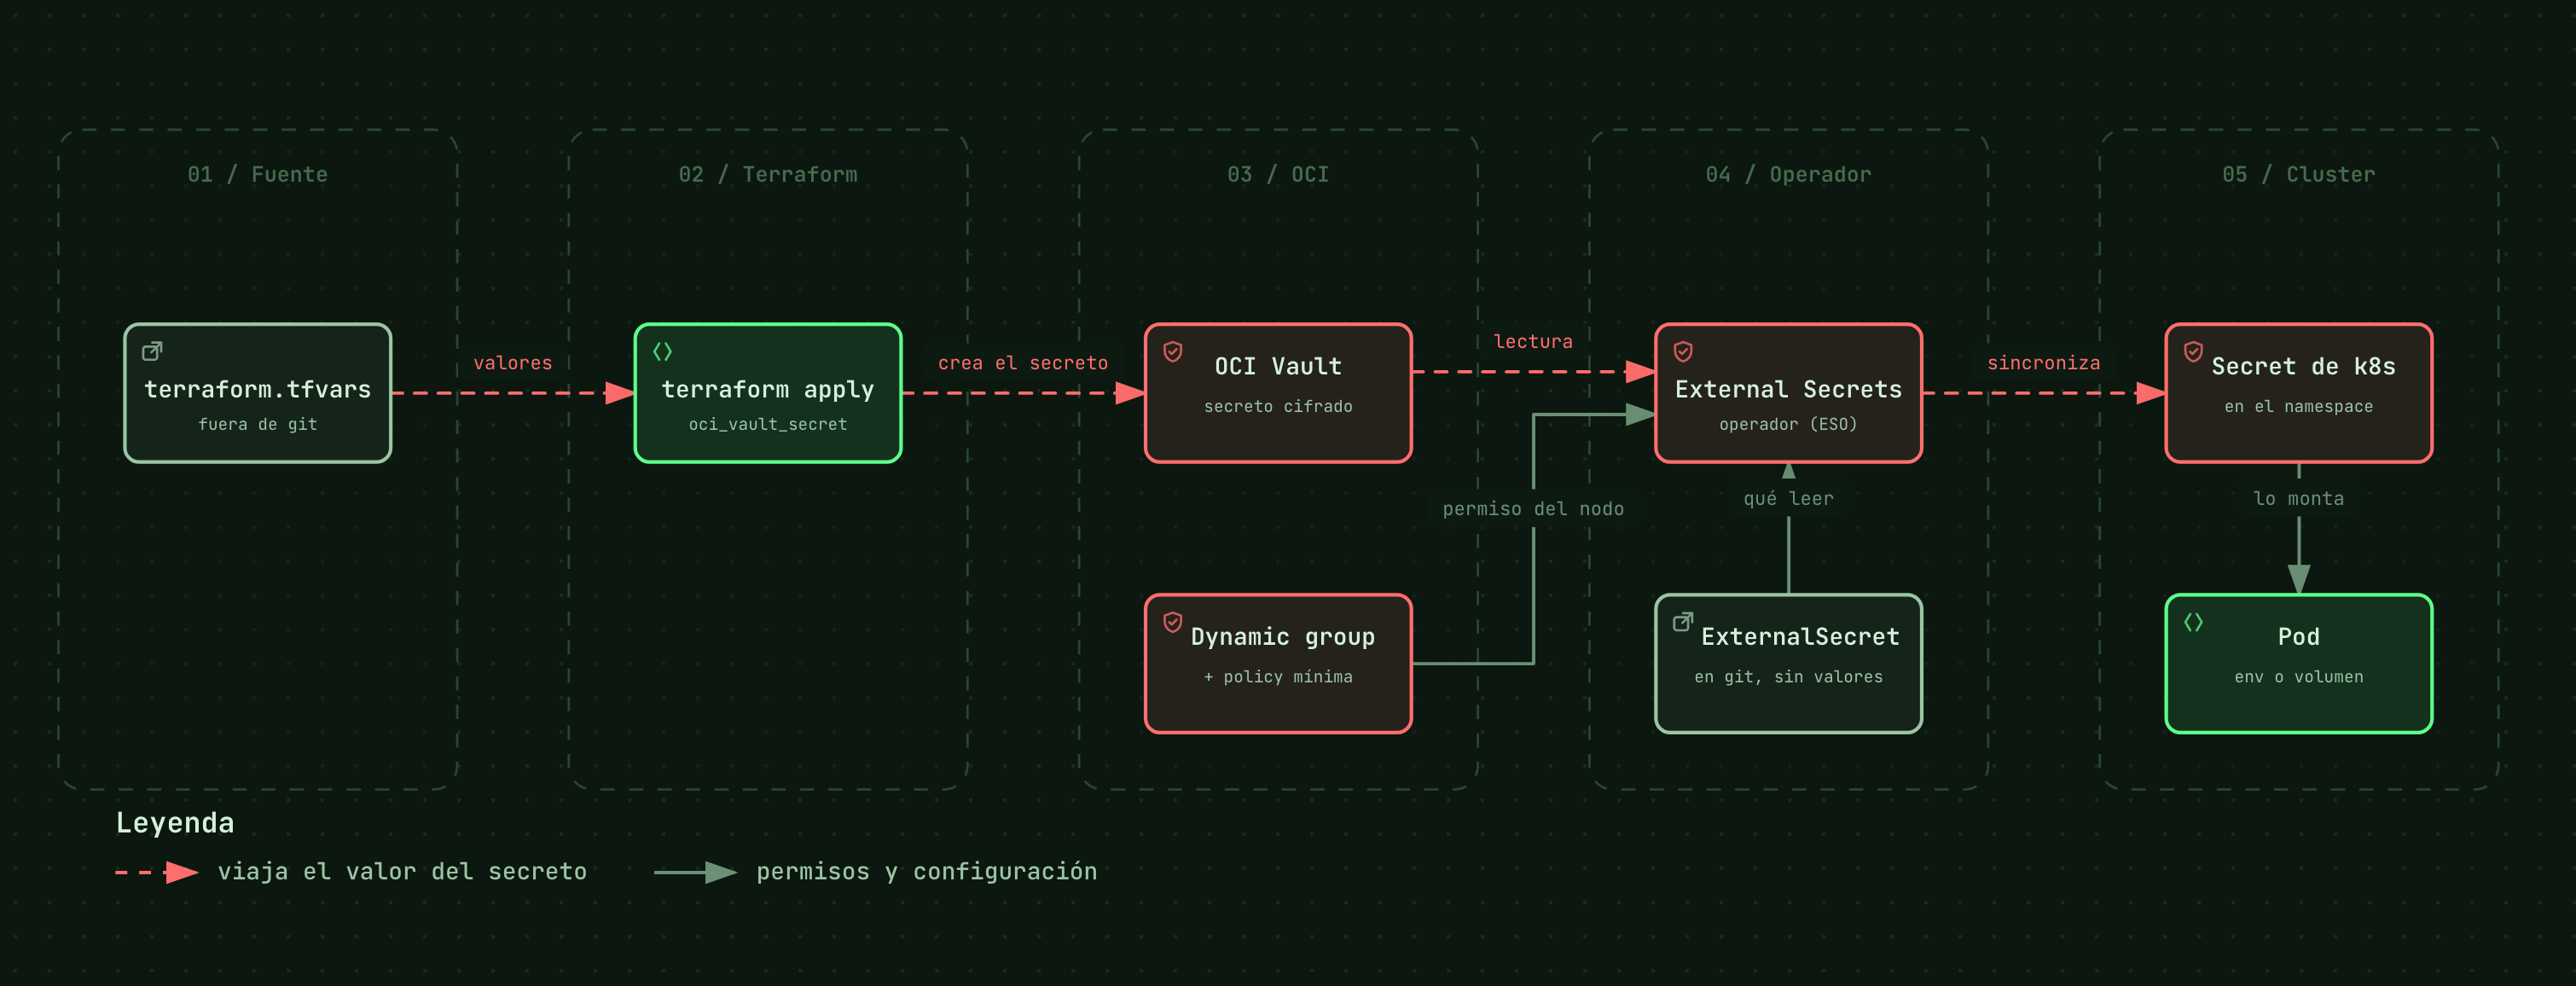
apiVersion: external-secrets.io/v1beta1   # ESO 0.14; desde 0.17 la API estable es external-secrets.io/v1
kind: ClusterSecretStore
metadata: { name: oci-vault }
spec:
  provider:
    oracle:
      vault: <vault_ocid>
      region: sa-santiago-1
      principalType: InstancePrincipal   # Basic no tiene workload identity
Diferencia con AWS: con IRSA o Pod Identity el permiso para leer Secrets Manager se le da
al service account de ESO. En OKE Basic se da con instance principal al nodo, mediante
un dynamic group y una policy (Allow dynamic-group oke-nodes to read secret-family in compartment
id <ocid> + use keys). Funciona, pero cualquier pod de ese nodo que use el SDK de OCI hereda
ese permiso, y también los demás que tenga el dynamic group (el cluster-autoscaler, por ejemplo,
necesita manage cluster-node-pools). Por eso las policies del dynamic group tienen que ser las
mínimas, y en un solo compartment.
3. Una request#
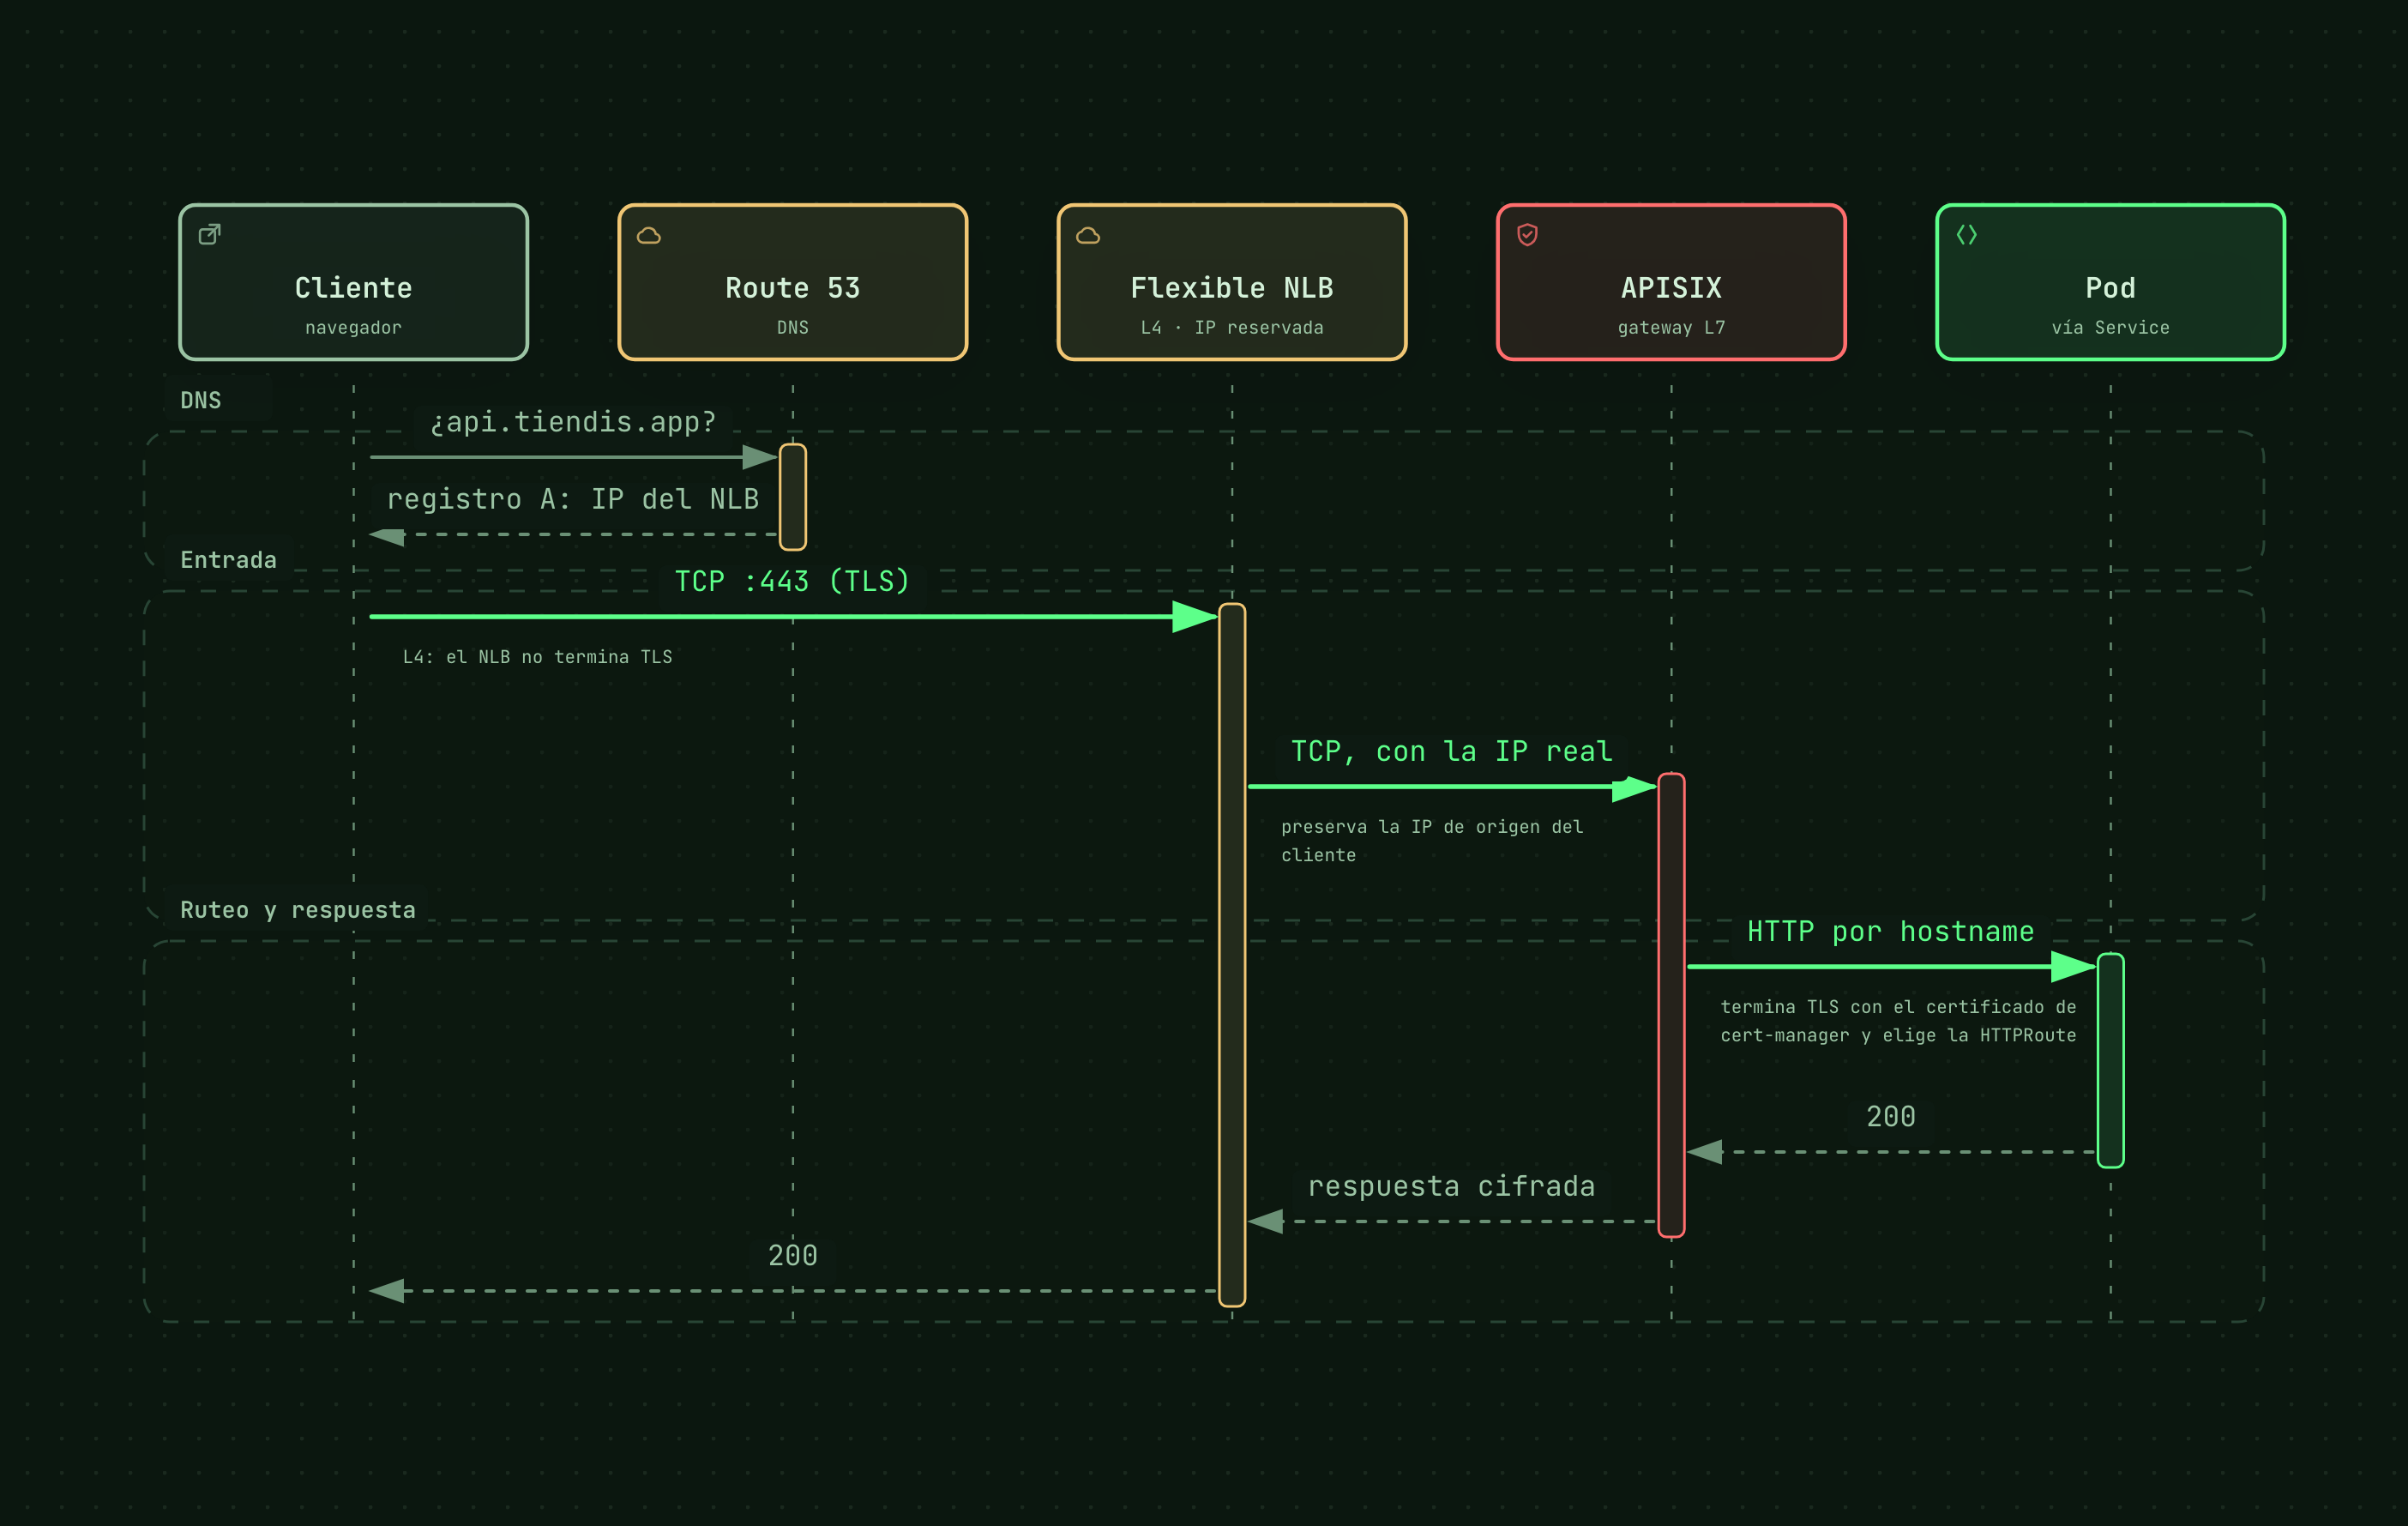
El NLB trabaja en L4 y el TLS lo termina APISIX con el certificado que emite cert-manager. En AWS lo normal es un ALB por Ingress, que termina TLS con ACM y cobra por hora y por LCU. Acá hay un NLB por entorno con IP reservada, y el ruteo L7 lo hace APISIX.
4. Una métrica, un log, una traza#
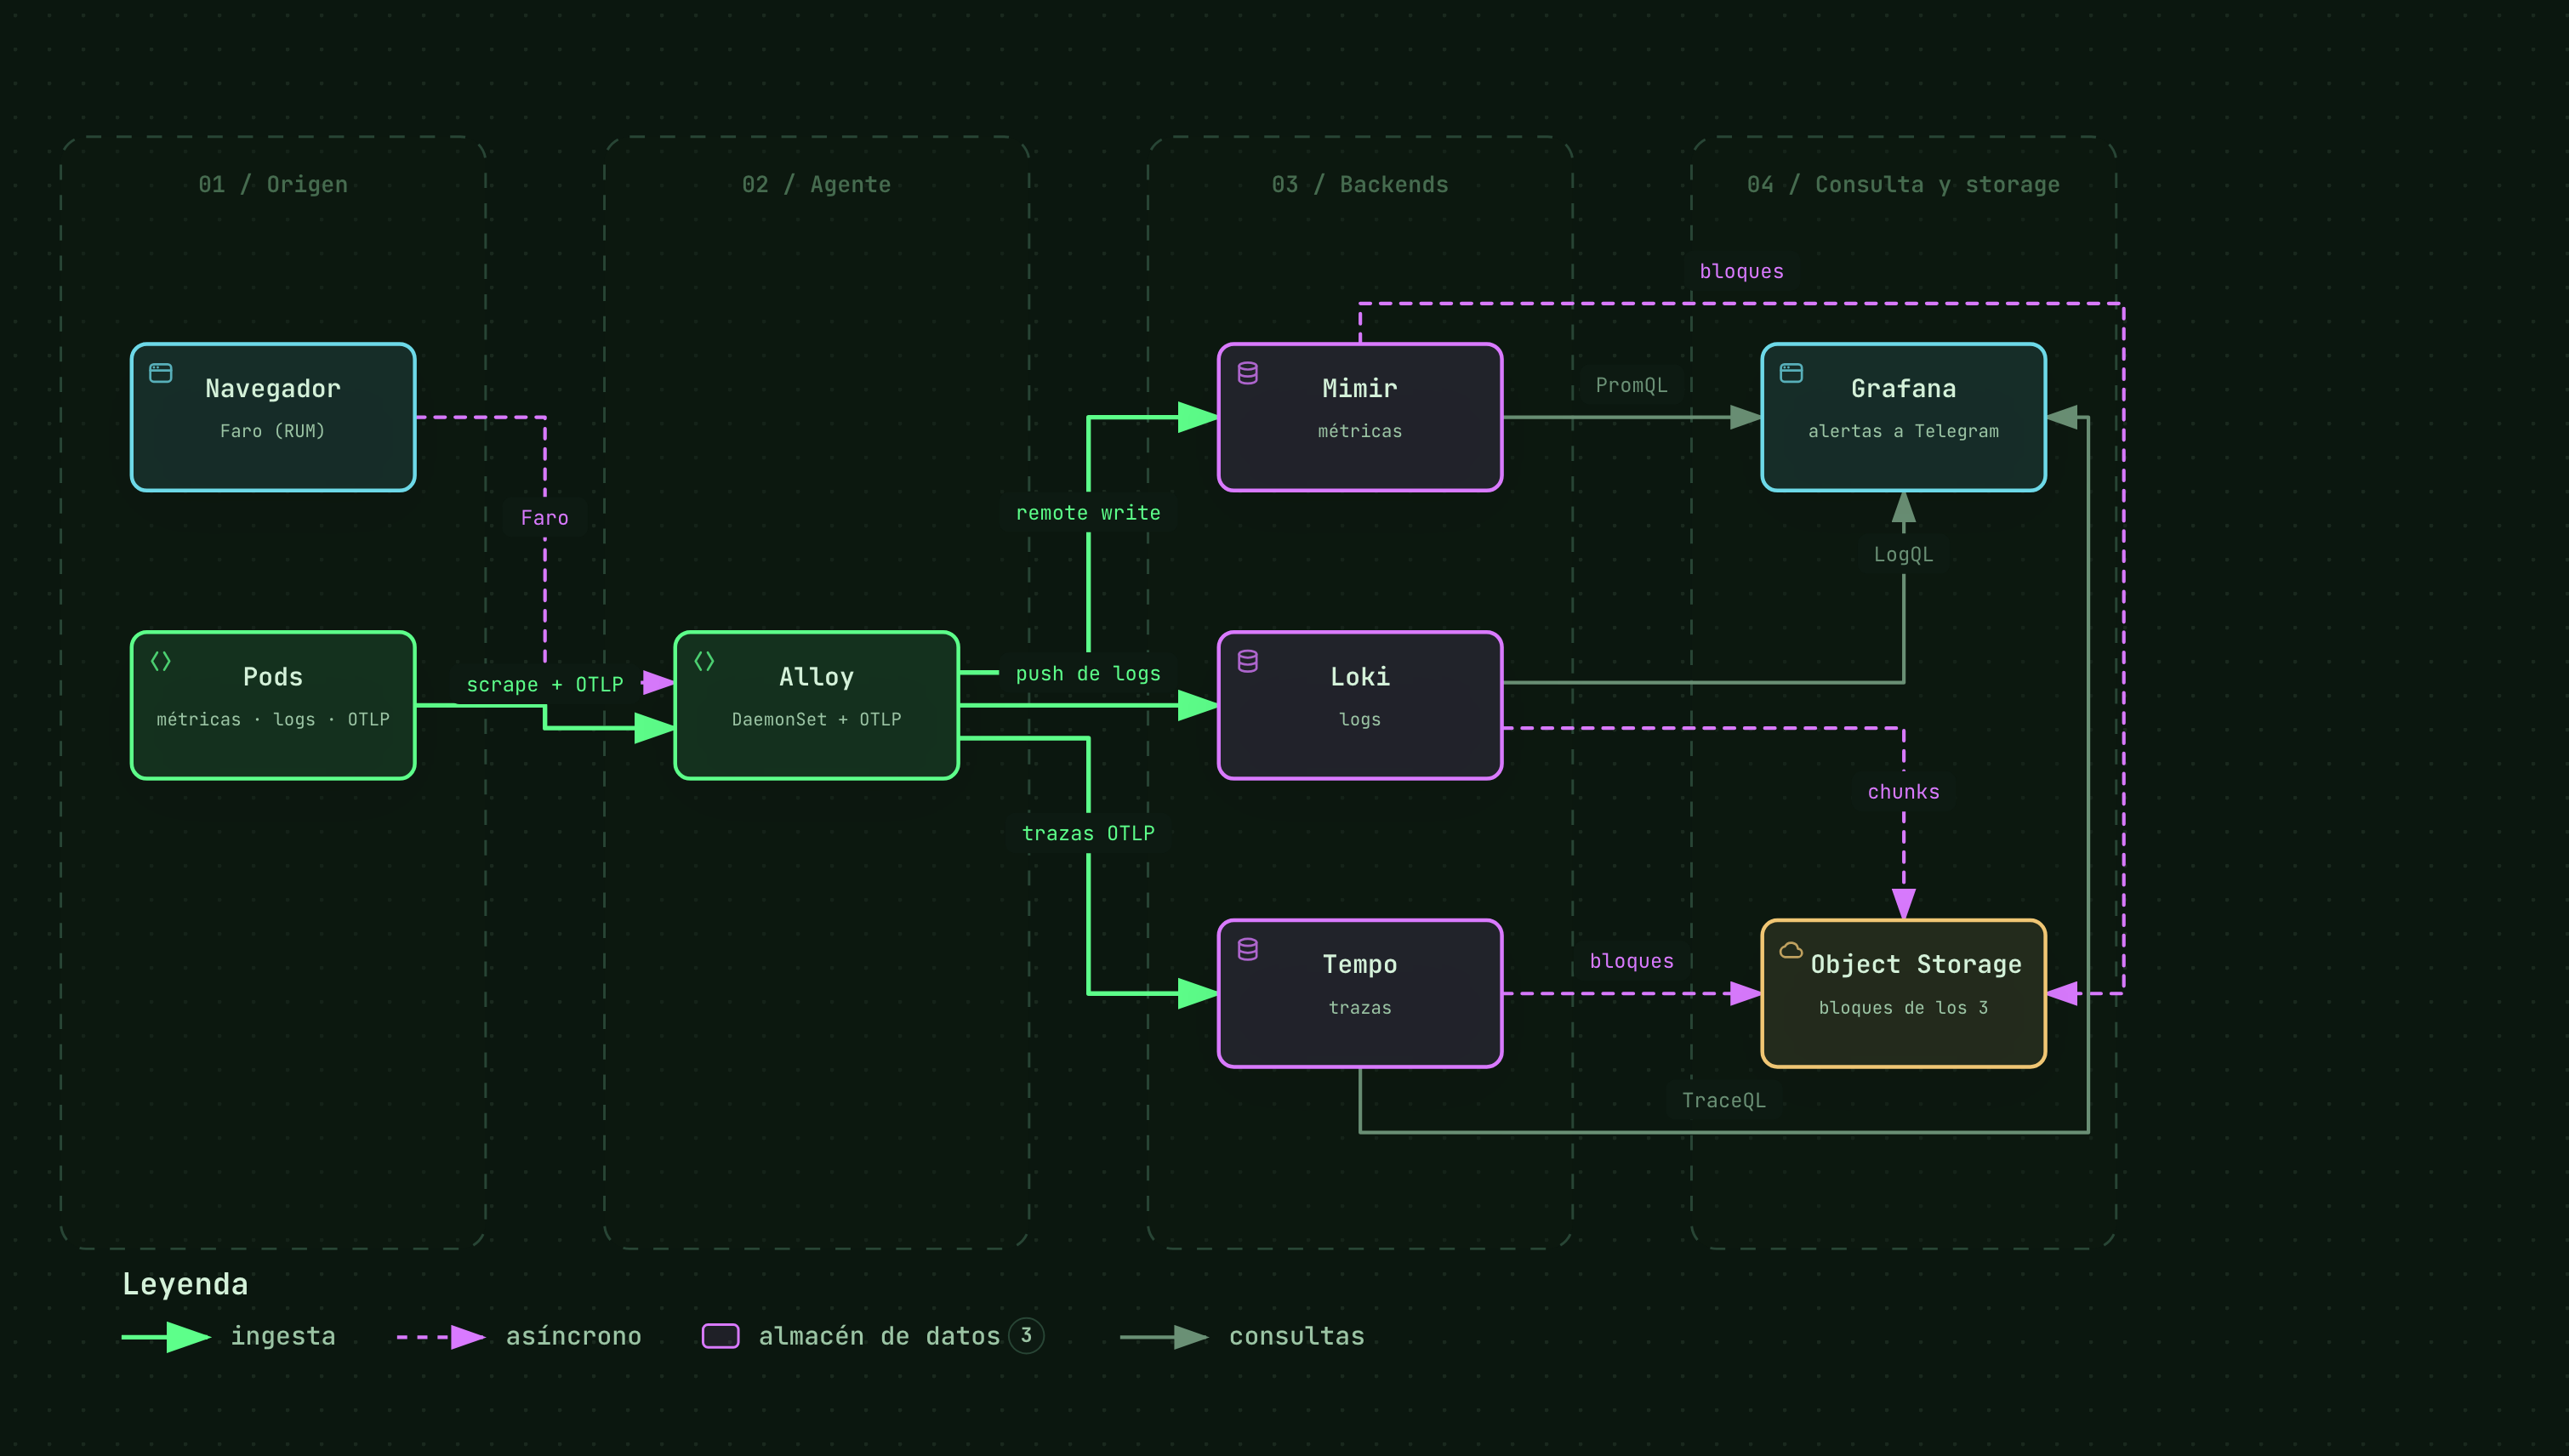
En AWS CloudWatch cobra por GB de logs ingerido y por métrica custom. Acá el costo es el storage, que es barato, más la RAM de los componentes, que no lo es tanto: en mi caso el stack de observabilidad es el mayor consumidor de memoria del cluster. Ese es el trade-off real.
NATS JetStream: por qué una sola pieza reemplaza cuatro#
NATS es un sistema de mensajería. JetStream le agrega persistencia: streams (logs de mensajes durables, parecidos a Kinesis o a un topic de Kafka), consumers (cursores con ack, parecidos a una cola SQS) y un Key-Value store encima. En Tiendis es la pieza sobre la que se apoyan varios patrones de integración, cada uno con su equivalente en AWS:
- Transactional outbox. La orden y su evento se guardan en la misma transacción de
Postgres; un proceso de fondo (
OrderOutboxProcessor) los toma con un lease y recién ahí publicacore.order.created/updateda JetStream, avisa en tiempo real al panel del comercio y dispara los efectos secundarios (el link de pago de MercadoPago, los mensajes del chat del pedido). Si NATS está caído, el evento no se pierde: queda pendiente y se reintenta. En AWS: el mismo outbox con SQS, o DynamoDB Streams / EventBridge Pipes. - Publish-subscribe con consumers durables. La integración con sistemas POS consume los streams de órdenes y de catálogo con un durable consumer y ack explícito: si el worker se reinicia, retoma donde quedó. Detrás, cada proveedor es un adapter que implementa la misma interfaz (ports & adapters), así sumar un POS nuevo no toca el core. En AWS: EventBridge + SQS.
- Cache-aside con invalidación por eventos. El storefront público se cachea en un bucket KV
y, cuando el comercio edita algo, un evento
storefront.invalidatedle llega a todos los pods del front SSR (fan-out). En AWS: ElastiCache + SNS con una SQS por consumidor. - Request-reply. El módulo de POS le pide al core el snapshot de catálogo o una orden por NATS, y el API le pide al worker que sincronice MercadoPago, sin exponer endpoints HTTP internos ni acoplar los servicios. En AWS: una API privada o una invocación de Lambda.
- Idempotency keys + lock distribuido. Las requests con
Idempotency-Keytoman un lock en KV, guardan el resultado y ante un reintento devuelven la misma respuesta sin volver a ejecutar (clave para no crear dos órdenes por un doble click o un reintento de red). En AWS: escrituras condicionales en DynamoDB. - Circuit breaker y degradación controlada. Si NATS no responde, un breaker compartido por todo el proceso se abre y las operaciones fallan rápido en vez de sumar timeouts; la coordinación (locks e idempotencia) cae a Postgres. La plataforma se degrada, no se cae.
- Señales efímeras a tiempo real. La disponibilidad de reservas viaja por NATS core (sin persistencia) a todos los pods del API, que la empujan al navegador por SSE. En AWS: API Gateway WebSockets + SNS.
- Caché de dependencias externas con TTL. Geocoding (90 días) y los tickets de autenticación de ARCA (12 h) viven en KV: menos latencia, menos costo y menos cupo consumido en APIs de terceros.
Lo que todavía no hay es CQRS: el storefront es cache-aside sobre el mismo modelo de escritura. Materializarlo como un modelo de lectura proyectado desde estos mismos eventos es el paso siguiente natural, y lo quiero desarrollar en un próximo post dedicado a JetStream.
nats stream ls                 # streams y cuántos mensajes/bytes tienen
nats consumer report STOREFRONT
nats kv ls                     # buckets KV
nats server report jetstream   # estado del cluster: quién es líder, réplicas al día
Corre como 3 réplicas con quórum (Raft). Esto es lo que más se paga en operación: si se pierden 2 de 3 nodos, JetStream deja de aceptar escrituras. A mí me pasó en EKS (6 horas sin quórum), y por eso en OKE cada réplica va en un fault domain distinto:
topologySpreadConstraints:
  - topologyKey: oci.oraclecloud.com/fault-domain   # en AWS: topology.kubernetes.io/zone
    maxSkew: 1
    minDomains: 3
    whenUnsatisfiable: DoNotSchedule
  - topologyKey: kubernetes.io/hostname             # y nunca dos réplicas en la misma VM
    maxSkew: 1
    minDomains: 3
    whenUnsatisfiable: DoNotSchedule
Ojo con el label. En una región de una sola AD,
topology.kubernetes.io/zonetiene un único valor y no reparte nada. El dominio de falla real en OKE esoci.oraclecloud.com/fault-domain. YminDomains: 3es imprescindible: sin él, 2+1 réplicas sobre dos dominios cumplenmaxSkew: 1y el scheduler no se queja.
Postgres con CloudNativePG#
CloudNativePG es un operador: vos declarás un Cluster y él crea el primario, las
réplicas, los servicios -rw/-ro, el failover y los backups.
kubectl cnpg status pg-prd -n databases     # plugin kubectl-cnpg
kubectl get backups,scheduledbackups -n databases
Los backups (WAL continuo + base backup diario) van con barman a Object Storage, con retención de 14 días. Eso permite restaurar a cualquier punto en el tiempo (PITR). Contra RDS: RDS te da todo esto con un checkbox y lo prueba por vos. Con CNPG el restore es tu responsabilidad, y si no lo probaste no tenés backups, tenés archivos. Restaurar en serio va a tener su propio post más adelante.
Lo que viene#
En las próximas partes, que todavía estoy escribiendo, vamos a construir todo con Terraform y comandos reales: estado y acceso, red, cluster y node pools, IAM, Vault + External Secrets, bootstrap de ArgoCD, operadores base, APISIX, CI en el cluster y control de costos. Y en paralelo, más adelante, una serie de cómo funciona para NATS, cada pata de la observabilidad, CNPG, APISIX y ArgoCD, siempre comparando con su equivalente en AWS.