Serie «Kubernetes en OCI al menor costo» — parte 4. En la parte 3 armamos la red. Ahora va el cluster y las máquinas donde corre todo.
Soy Matías Galiano, arquitecto de plataforma: llevo 18 años escribiendo software y 7 diseñando y operando sistemas distribuidos sobre Kubernetes, con Terraform y GitOps.
Esta es la parte donde más cosas fui cambiando sobre la marcha. El tamaño de los nodos, cómo se reparten y el autoscaler los ajusté varias veces, y casi siempre después de que algo me mostrara que la primera versión no alcanzaba. Cuento lo que tengo hoy y cómo llegué hasta acá.
Todo sale del Terraform del cluster de producción de Tiendis (oke.tf y
nodepools.tf) y de la configuración del autoscaler en el repo de GitOps.
El cluster: OKE Basic#
resource "oci_containerengine_cluster" "oke" {
  compartment_id     = var.compartment_ocid
  name               = "proyectos"
  vcn_id             = oci_core_vcn.main.id
  kubernetes_version = "v1.37.1"
  type               = "BASIC_CLUSTER"   # control plane sin costo, sin SLA

  endpoint_config {
    subnet_id            = oci_core_subnet.public.id
    is_public_ip_enabled = true
    nsg_ids              = [oci_core_network_security_group.cp_endpoint.id]
  }

  cluster_pod_network_options {
    cni_type = "FLANNEL_OVERLAY"
  }

  options {
    service_lb_subnet_ids = [oci_core_subnet.public.id]
    kubernetes_network_config {
      pods_cidr     = "10.244.0.0/16"
      services_cidr = "10.96.0.0/16"
    }
  }
}
Sobre el FLANNEL_OVERLAY, en criollo: cada pod necesita una dirección IP para que los demás lo
encuentren. Con flannel, Kubernetes arma su propia red "por arriba" de la red de OCI: los pods
reciben direcciones de un rango aparte (10.244.0.0/16), y cuando un pod le habla a otro que está
en otro nodo, flannel mete ese mensaje dentro de un paquete normal entre los dos nodos, como una
carta dentro de otro sobre. La red de OCI solo ve tráfico entre nodos y no se entera de que hay
pods. La alternativa (VCN-native) le da a cada pod una IP real de la subnet, como hace EKS. En la
parte 3 cuento por qué elegí flannel y qué me costó.
OKE tiene dos tipos de cluster. Basic no cobra el control plane, pero no tiene SLA con respaldo financiero. Enhanced cuesta USD 0,10 por hora (unos USD 74 por mes) y suma el SLA, workload identity y los nodos virtuales. Para el tamaño de mis proyectos elegí Basic: son USD 74 menos por mes, y la falta de workload identity la resolví con instance principal (lo cuento en una próxima entrega).
Una vez creado, el kubeconfig se genera con la CLI:
oci ce cluster create-kubeconfig --cluster-id <cluster_ocid> --region sa-santiago-1 \
  --file ~/.kube/config --token-version 2.0.0 --kube-endpoint PUBLIC_ENDPOINT
Diferencia con AWS: EKS cobra el control plane siempre (USD 0,10 por hora, y USD 0,60 si la versión pasa a soporte extendido). En OCI se puede no pagarlo, a cambio del SLA.
Las versiones vencen. OKE soporta pocas versiones de Kubernetes a la vez: la v1.36.1 que corría quedó fuera de soporte el 3 de noviembre, y pasé a la v1.37.1. El orden fue el de siempre: primero el control plane (sin corte) y después los nodos, que OKE va reemplazando por nodos nuevos con la versión actualizada. Durante esa rotación conviene pausar el scale-down del autoscaler; más abajo cuento por qué.
La imagen de los nodos#
Los nodos usan la imagen de Oracle Linux que publica OKE para cada versión de Kubernetes. En lugar de fijar un OCID a mano, la busco con un filtro, así al subir de versión la imagen se actualiza sola:
data "oci_containerengine_node_pool_option" "oke" {
  node_pool_option_id = "all"
  compartment_id      = var.compartment_ocid
}

locals {
  arm_sources = [
    for s in data.oci_containerengine_node_pool_option.oke.sources : s
    if can(regex("^Oracle-Linux-9\\..*aarch64", s.source_name)) &&          # OL9 y ARM
       !can(regex("GPU", s.source_name)) &&
       can(regex("OKE-${trimprefix(var.kubernetes_version, "v")}-", s.source_name))
  ]
  # Ordenadas por nombre, la más nueva de esa versión queda última
  node_image_id = [for n in sort([for s in local.arm_sources : s.source_name]) :
    one([for s in local.arm_sources : s if s.source_name == n])][length(local.arm_sources) - 1].image_id
}
Pedir Oracle Linux 9 de forma explícita me evitó un problema: sin ese filtro, el primer resultado podía ser una imagen de Oracle Linux 8.
El cloud-init: cri-o y los nombres cortos#
Kubernetes no corre los contenedores por sí mismo: en cada nodo, el kubelet (el agente que recibe las órdenes del cluster) le pide a un runtime de contenedores que baje la imagen y arranque el proceso. Es la pieza que antes hacía Docker; hoy los más comunes son containerd, el que usa EKS, y cri-o, uno hecho específicamente para Kubernetes. En el día a día no se nota cuál hay, porque los manifiestos son los mismos, pero cada uno tiene sus valores por defecto.
OKE usa cri-o, y cri-o viene configurado para rechazar imágenes con nombre corto. Un
image: nats:2.12 falla con ImageInspectError en vez de bajar docker.io/nats:2.12. Muchos
charts de Helm usan nombres cortos, así que lo resolví en el arranque del nodo:
locals {
  node_cloud_init = <<-EOT
    #!/usr/bin/env bash
    mkdir -p /etc/containers/registries.conf.d
    printf 'short-name-mode = "permissive"\nunqualified-search-registries = ["docker.io"]\n' \
      > /etc/containers/registries.conf.d/99-shortnames.conf
    # El script de OKE que une el nodo al cluster: hay que llamarlo sí o sí
    curl --fail -H "Authorization: Bearer Oracle" -L0 \
      http://169.254.169.254/opc/v2/instance/metadata/oke_init_script | base64 --decode > /var/run/oke-init.sh
    bash /var/run/oke-init.sh
  EOT
}
El detalle importante es la última parte: al pasar un user_data propio se reemplaza el que trae
OKE, así que hay que bajar y ejecutar oke_init_script a mano. Sin eso, el nodo arranca pero
nunca se une al cluster.
Diferencia con AWS: EKS usa containerd, que completa los nombres cortos con docker.io sin
quejarse. Este problema no existe ahí.
El node pool: de 6 nodos chicos a 3 grandes#
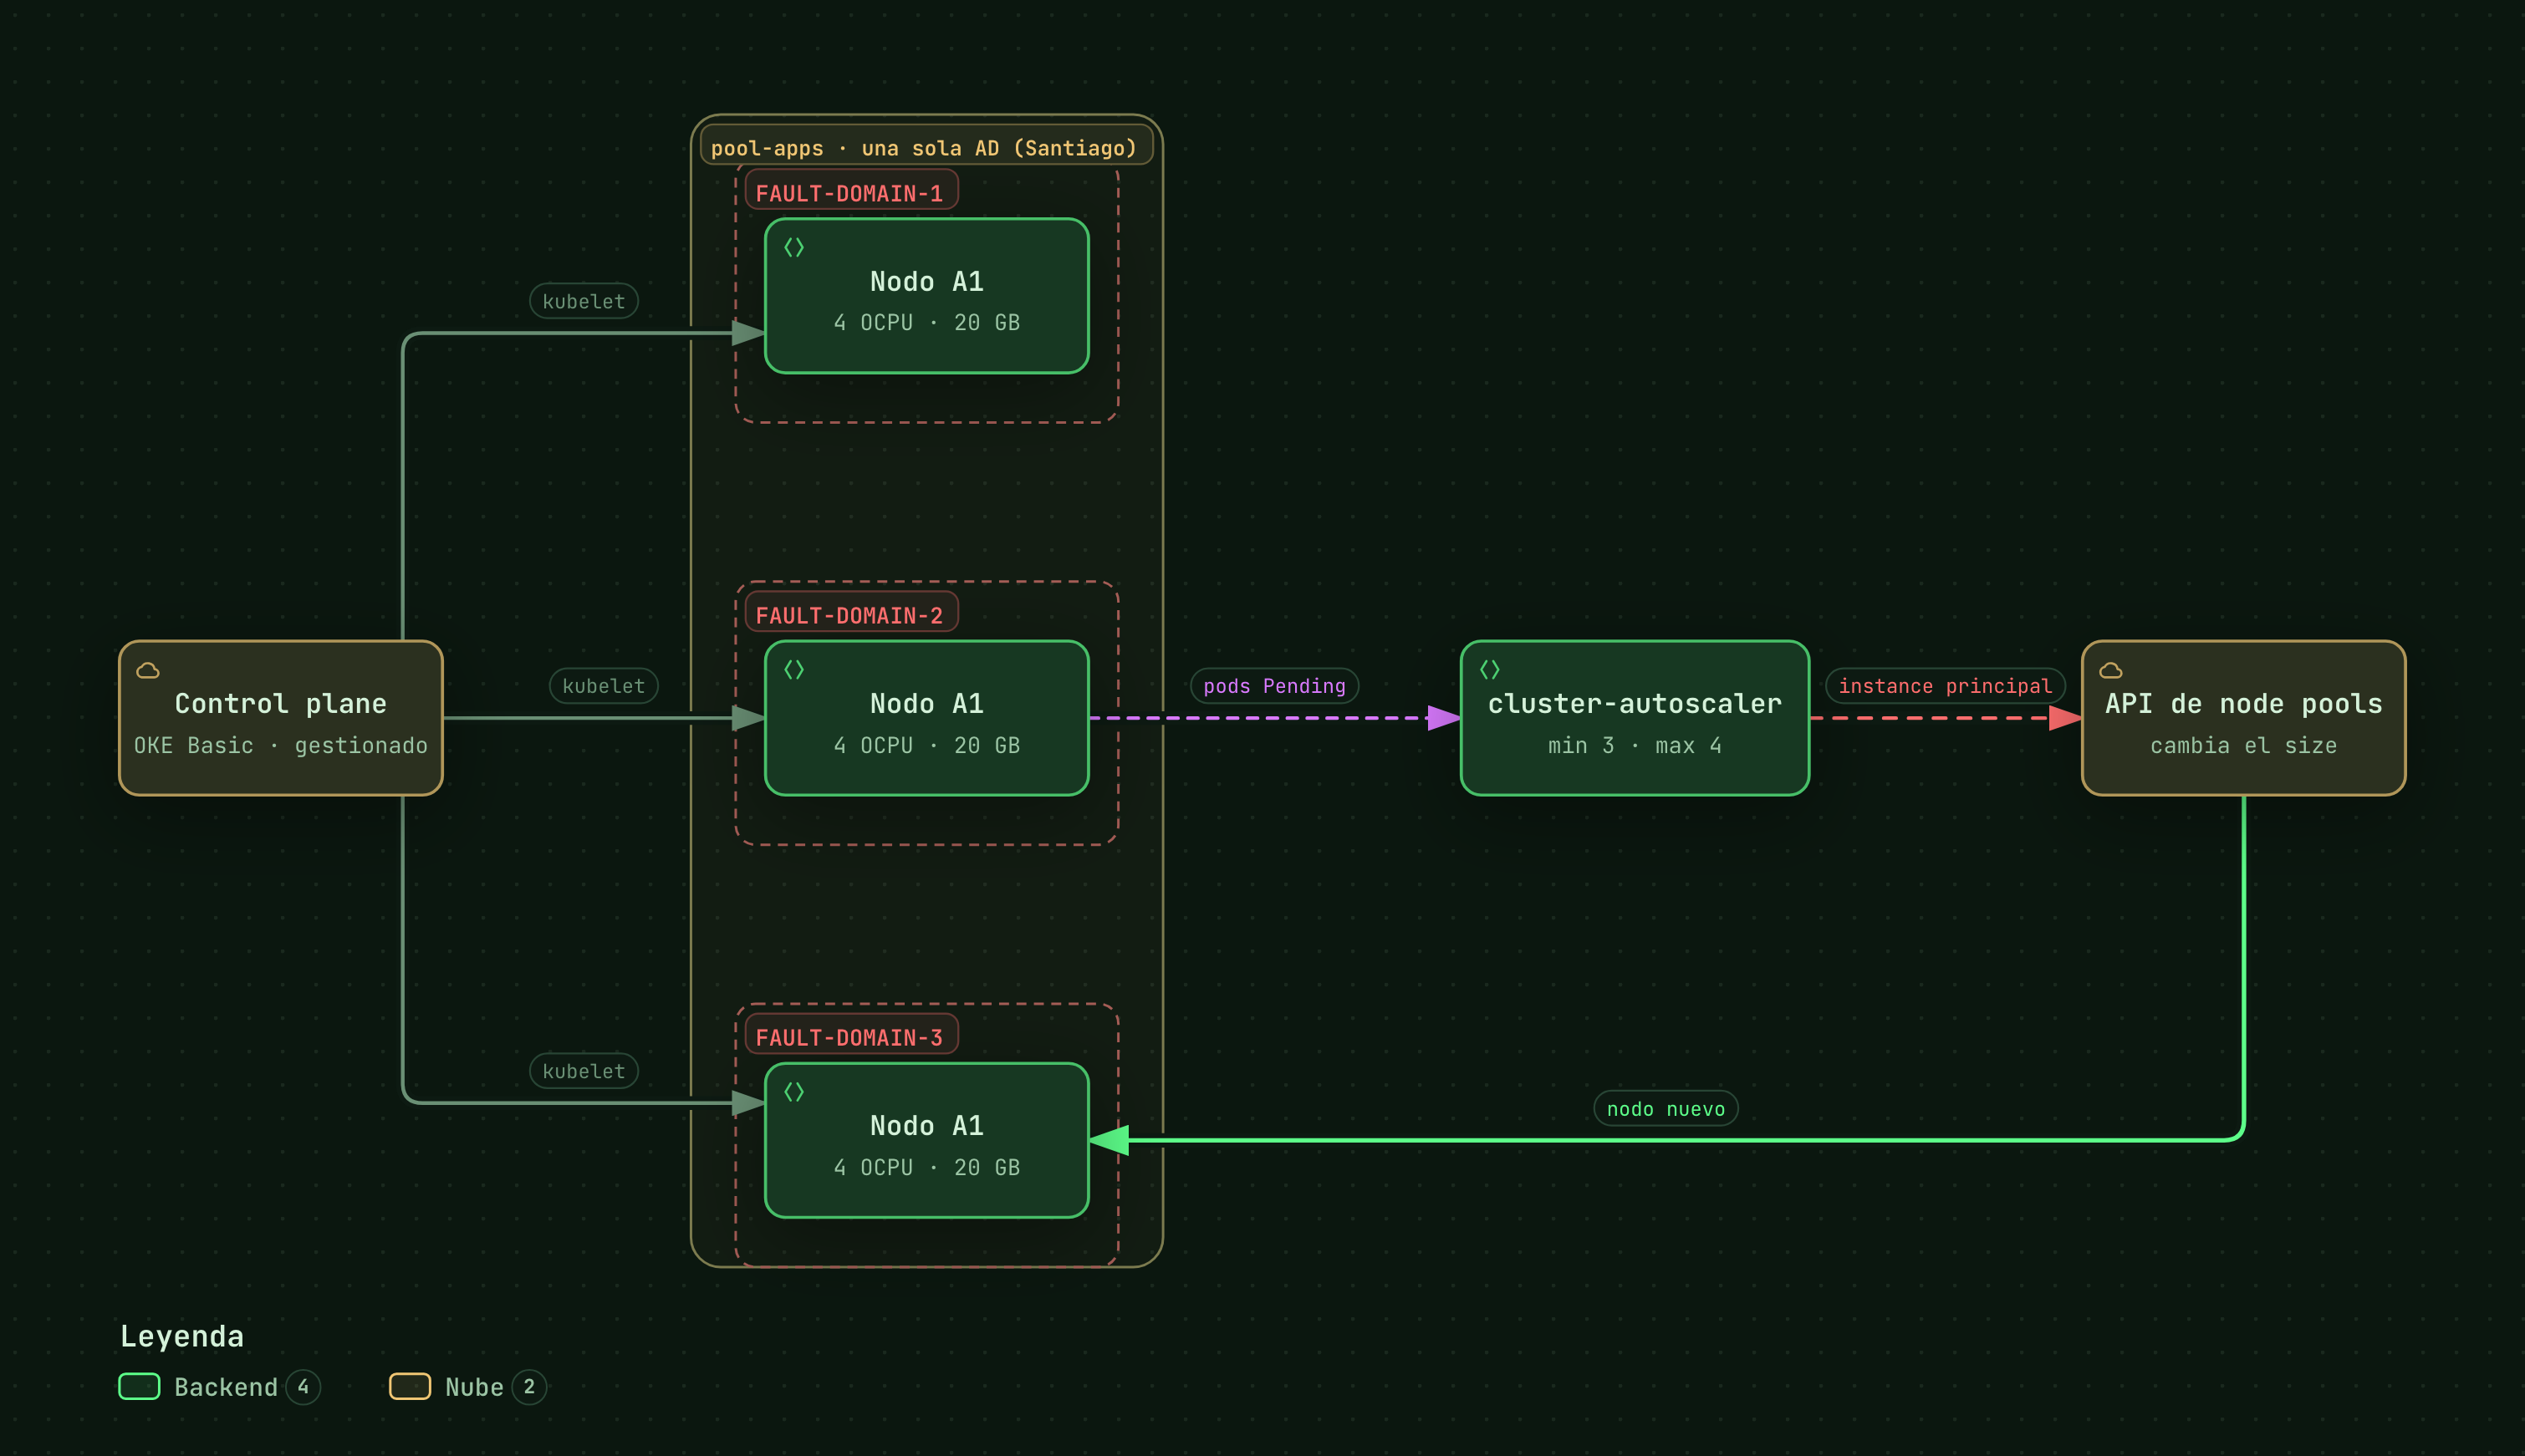
Abrí el diagrama interactivo para recorrerlo pieza por pieza.
Arranqué con 6 nodos de 2 OCPU y 12 GB. Hoy son 3 nodos de 4 OCPU y 20 GB, uno por fault domain, y el autoscaler puede sumar un cuarto:
resource "oci_containerengine_node_pool" "apps" {
  cluster_id         = oci_containerengine_cluster.oke.id
  compartment_id     = var.compartment_ocid
  name               = "pool-apps"
  kubernetes_version = var.kubernetes_version
  node_shape         = "VM.Standard.A1.Flex"
  node_metadata      = { user_data = base64encode(local.node_cloud_init) }

  node_shape_config {
    ocpus         = 4
    memory_in_gbs = 20
  }

  node_source_details {
    source_type             = "IMAGE"
    image_id                = local.node_image_id
    boot_volume_size_in_gbs = 50
  }

  node_config_details {
    size = 3
    placement_configs {
      availability_domain = local.ad_name
      subnet_id           = oci_core_subnet.private.id
      fault_domains       = local.fd_names   # los tres, en un solo placement_config
    }
    nsg_ids = [oci_core_network_security_group.workers.id]
  }

  initial_node_labels {
    key   = "pool"
    value = "apps"
  }

  ssh_public_key = var.ssh_public_key

  # El tamaño lo maneja el cluster-autoscaler
  lifecycle {
    ignore_changes = [node_config_details[0].size]
  }
}
Por qué el cambio, con los números de OCI (que cobra por OCPU y por GB, no por instancia):
- La CPU total es la misma: 12 OCPU antes y después, así que el cómputo no cambia.
- Baja la RAM: de 72 GB a 60 GB, y en OCI la RAM pesa casi tanto como la CPU.
- La mitad de discos de boot: 50 GB es el mínimo por nodo, y con 3 nodos pago 3 discos en vez de 6.
- Un nodo por fault domain: con 6 nodos repartidos 3/2/1, separar por nodo y por fault domain a la vez no cerraba; con 3, una réplica por nodo es lo mismo que una por fault domain.
La contrapartida es real: cada nodo es un tercio del cluster. Si se cae uno, la réplica de
Postgres o de NATS de ese fault domain queda Pending hasta que el pool recrea el nodo, unos 5 a
8 minutos. Para mí es un costo aceptable; para otro proyecto quizás no.
El reparto por fault domain que se me rompió#
Al principio tenía un placement_config por fault domain, tres bloques, uno por nodo. Funcionó
hasta que entró el autoscaler. El autoscaler solo cambia el size del pool y no sabe repartirlo
entre varios placement_configs, así que con el tiempo el pool derivó a uno solo, y un día
encontré los 4 nodos en FAULT-DOMAIN-1:
kubectl get nodes -L oci.oraclecloud.com/fault-domain
Con todos los nodos en el mismo hardware, Postgres y NATS, que exigen una réplica por fault domain,
quedaban con una sola réplica programable y el resto en Pending:
topologySpreadConstraints:
  - topologyKey: oci.oraclecloud.com/fault-domain
    maxSkew: 1
    minDomains: 3
    whenUnsatisfiable: DoNotSchedule
La solución fue un solo placement_config con la lista de los tres fault domains, como está
arriba. Así OKE reparte cada nodo nuevo entre los tres, incluidos los que crea el autoscaler, y el
reparto se sostiene solo.
El label que importa. En una región con una sola AD, como Santiago,
topology.kubernetes.io/zonetiene un único valor y no reparte nada. El dominio de falla real esoci.oraclecloud.com/fault-domain: hardware físico distinto dentro de la misma AD.
El cluster-autoscaler#
En OKE no hay Karpenter ni Auto Mode: se usa el cluster-autoscaler clásico, con el proveedor de OCI. Lo instalo con ArgoCD, y estos son los valores que importan:
cloudProvider: oci

autoscalingGroups:
  - name: <node_pool_ocid>   # pool-apps
    minSize: 3
    maxSize: 4

extraEnv:
  OCI_USE_INSTANCE_PRINCIPAL: "true"   # usa el permiso del nodo, sin llaves
  OCI_REGION: sa-santiago-1

extraArgs:
  balance-similar-node-groups: "true"
  scale-down-unneeded-time: 5m
  scale-down-delay-after-add: 5m

image:
  tag: v1.37.0   # misma minor que Kubernetes
Tres cosas que aprendí con él:
- La versión va pegada a la de Kubernetes. El autoscaler se versiona por minor de Kubernetes. En algún momento quedó en la v1.32 con el cluster en la v1.36, cuatro minors atrás, y entre otras cosas logueaba errores de permisos. Desde entonces lo subo junto con el cluster.
- Necesita permiso sobre los node pools. Con instance principal, el permiso es del nodo: la
policy del dynamic group de los nodos tiene que incluir
manage cluster-node-pools. - Ojo al rotar nodos a mano. Un nodo recién creado arranca casi vacío, y el autoscaler lo marca
como innecesario y a los 5 minutos lo borra. Me pasó en plena rotación: se comió el nodo nuevo de
un fault domain. Ahora, antes de rotar, pongo
scale-down-enabled: "false"y lo vuelvo a activar al terminar.
El maxSize: 4 también tiene su historia: con nodos de 2 OCPU el techo era 6; al pasar a nodos de
4 OCPU, mantener 6 habría sido un techo de 24 OCPU. Con 3 nodos el cluster corre entre el 27 y el
70 % de CPU, así que un cuarto nodo alcanza como margen.
Diferencia con AWS: Karpenter (o EKS Auto Mode) elige el tipo de instancia en el momento, según lo que piden los pods. El cluster-autoscaler de OKE solo cambia el tamaño de pools que ya existen: la forma del nodo la decidís vos de antemano.
Lo que todavía tengo pendiente: el pool de CI#
Creé un segundo pool, pool-ci, pensado para los runners de CI: nodos de 2 OCPU y 8 GB, con disco
de 100 GB para la caché de builds, que arrancara en 0 y escalara a 2 solo cuando hubiera un build.
Hoy ese pool está en 0 y no se usa: no lo registré en el autoscaler y los runners no lo piden,
así que los builds corren en los nodos de apps, al lado de producción. Y eso ya me jugó en
contra: un día tres builds con Docker en Docker al mismo tiempo colgaron cri-o y dejaron un nodo
NotReady, con pods de producción adentro. La solución rápida fue lanzar los releases de a uno.
La solución de fondo es terminar lo que empecé:
- Registrar
pool-cien el autoscaler conminSize: 0ymaxSize: 2. - Ponerle un taint al pool, para que solo los runners puedan correr ahí.
- Darle a los runners la toleration y un
nodeSelectorconpool: ci.
Lo voy a contar cuando lo termine, en la entrega del CI dentro del cluster.
Resumen: lo mismo en AWS y en OCI#
| Tema | AWS (EKS) | OCI (OKE) |
|---|---|---|
| Control plane | USD 0,10/h siempre | Basic sin costo (sin SLA) o Enhanced USD 0,10/h |
| Imagen de nodos | AMI de EKS optimizada | Oracle Linux de OKE, elegida con filtro |
| Runtime | containerd | cri-o (ojo con los nombres cortos) |
| Autoscaling | Karpenter / Auto Mode eligen la instancia | cluster-autoscaler sobre pools existentes |
| Dominio de falla | AZ (topology.kubernetes.io/zone) |
Fault domain (oci.oraclecloud.com/fault-domain) |
| Permiso del autoscaler | IRSA / Pod Identity | Instance principal (del nodo) |
Lo que viene#
En la próxima entrega, que todavía estoy escribiendo, va el IAM de los nodos: dynamic groups, instance principal y qué significa, en la práctica, que el permiso sea del nodo y no del pod.
Si te sirvió, el RSS es la mejor forma de enterarte del próximo post.