Serie «Kubernetes en OCI al menor costo» — parte 3. En la parte 2 dejamos lista la cuenta, la identidad y el state. Acá va la red donde después vive el cluster.
Soy Matías Galiano, arquitecto de plataforma: llevo 18 años escribiendo software y 7 diseñando y operando sistemas distribuidos sobre Kubernetes, con Terraform y GitOps.
En AWS la red fue, durante meses, una de las partes más caras de mi factura: en julio, el NAT Gateway y el tráfico entre zonas sumaron más de USD 80, no tan lejos de lo que costaba el cómputo. En OCI esa misma red no se cobra. Pero que sea gratis no significa que dé igual cómo se arma, y acá cuento cómo la armé, qué decidí y qué fui ajustando.
Todo sale del network.tf que hoy usa el cluster de producción de
Tiendis. Donde veas algo entre < y >, va el valor de tu cuenta.
El diseño completo#
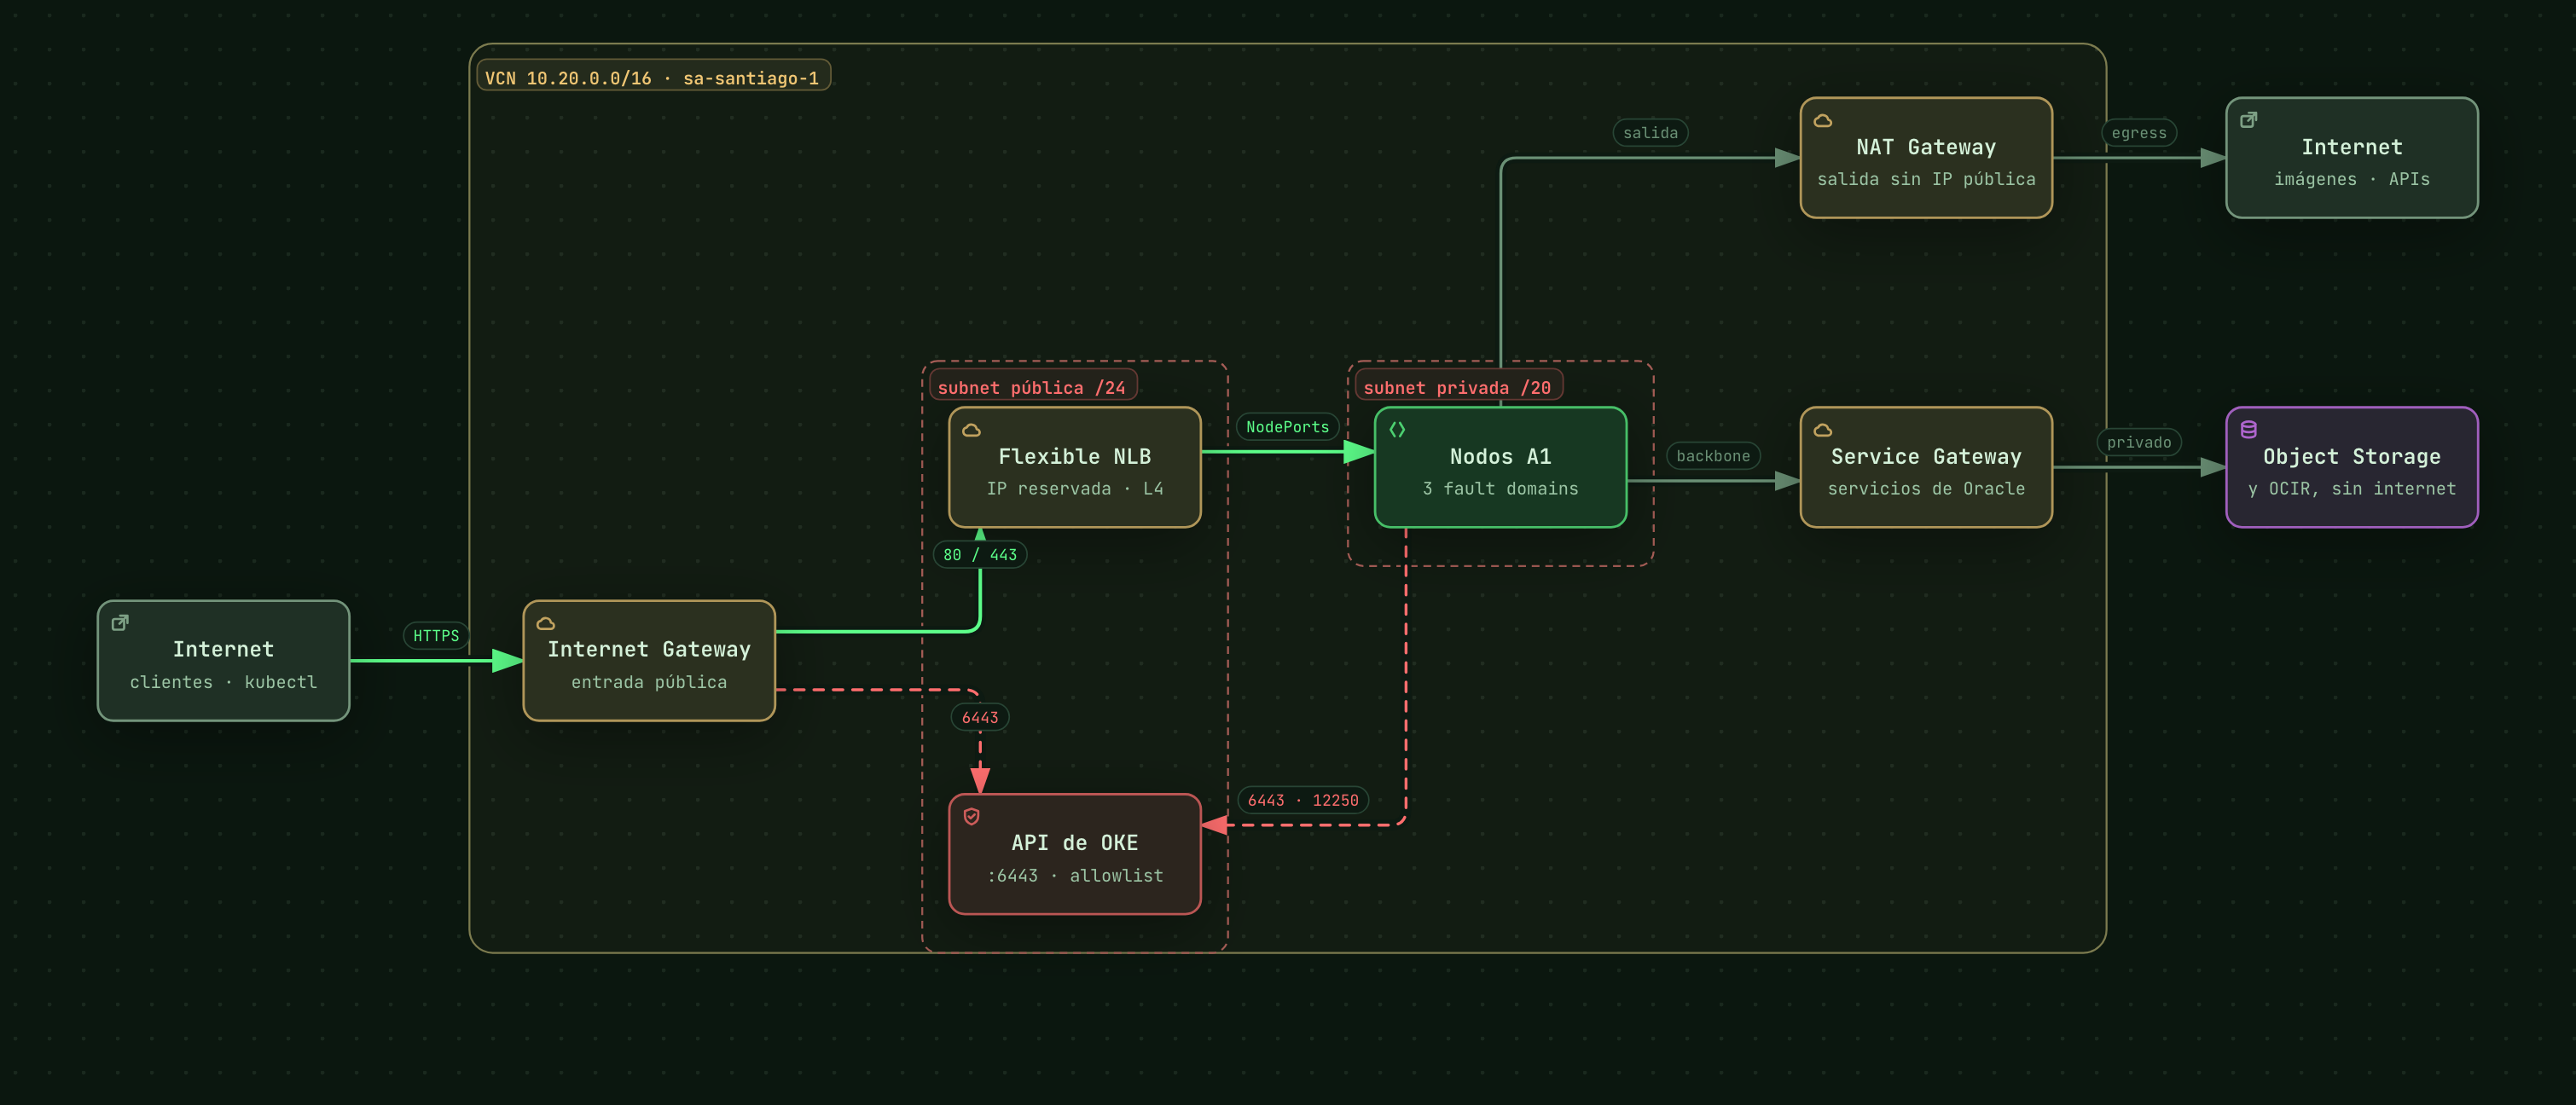
Abrí el diagrama interactivo para recorrerlo pieza por pieza.
Es una sola VCN (10.20.0.0/16) con dos subnets:
- Pública (
/24): solo el load balancer de entrada y el endpoint de la API de Kubernetes. - Privada (
/20): los nodos. No tienen IP pública; salen a internet por el NAT y a los servicios de Oracle por el Service Gateway.
resource "oci_core_vcn" "main" {
  compartment_id = var.compartment_ocid
  cidr_blocks    = ["10.20.0.0/16"]
  display_name   = "oke-vcn"
  dns_label      = "oke"
}

resource "oci_core_subnet" "public" {
  compartment_id             = var.compartment_ocid
  vcn_id                     = oci_core_vcn.main.id
  cidr_block                 = cidrsubnet("10.20.0.0/16", 8, 0)   # 10.20.0.0/24
  display_name               = "subnet-public"
  dns_label                  = "public"
  route_table_id             = oci_core_route_table.public.id
  prohibit_public_ip_on_vnic = false
}

resource "oci_core_subnet" "private" {
  compartment_id             = var.compartment_ocid
  vcn_id                     = oci_core_vcn.main.id
  cidr_block                 = cidrsubnet("10.20.0.0/16", 4, 1)   # 10.20.16.0/20
  display_name               = "subnet-private"
  dns_label                  = "private"
  route_table_id             = oci_core_route_table.private.id
  prohibit_public_ip_on_vnic = true
}
Diferencia con AWS: en una VPC cada subnet vive en una zona de disponibilidad, así que para tener alta disponibilidad terminás con una pública y una privada por AZ, y un NAT Gateway por zona si no querés que la caída de una se lleve la salida de todas. En OCI las subnets son regionales: una alcanza para todos los fault domains (y en Santiago, que tiene una sola AD, para todo el cluster). Son dos subnets en lugar de seis.
Los tres gateways#
resource "oci_core_internet_gateway" "igw" {
  compartment_id = var.compartment_ocid
  vcn_id         = oci_core_vcn.main.id
  display_name   = "igw"
}

resource "oci_core_nat_gateway" "nat" {
  compartment_id = var.compartment_ocid
  vcn_id         = oci_core_vcn.main.id
  display_name   = "nat"
}

# "All <región> Services In Oracle Services Network": Object Storage, OCIR, Vault…
data "oci_core_services" "all" {
  filter {
    name   = "name"
    values = ["All .* Services In Oracle Services Network"]
    regex  = true
  }
}

resource "oci_core_service_gateway" "sgw" {
  compartment_id = var.compartment_ocid
  vcn_id         = oci_core_vcn.main.id
  display_name   = "sgw"
  services { service_id = data.oci_core_services.all.services[0]["id"] }
}
- Internet Gateway: la entrada y salida de la subnet pública.
- NAT Gateway: la salida de los nodos, para bajar imágenes de Docker Hub o llamar APIs externas, sin que tengan IP pública.
- Service Gateway: el que más valor me dio. Todo el tráfico hacia los servicios de Oracle (bajar imágenes de OCIR, los backups y las métricas en Object Storage, leer Vault) va por la red interna de Oracle y no pasa por el NAT.
Diferencia con AWS: el NAT Gateway se cobra por hora y por GB procesado, y es fácil que se lleve una parte importante de la factura sin que nadie lo note. Para que el tráfico a S3 no pase por ahí está el gateway endpoint de S3 (gratis), pero ECR, Secrets Manager o CloudWatch necesitan interface endpoints, que se cobran por hora y por zona. En OCI, un solo Service Gateway cubre todos los servicios de Oracle, y ni él ni el NAT ni el Internet Gateway se cobran.
Las route tables#
Una por subnet. La privada tiene dos reglas: lo que va a los servicios de Oracle sale por el Service Gateway, y todo lo demás por el NAT.
resource "oci_core_route_table" "public" {
  compartment_id = var.compartment_ocid
  vcn_id         = oci_core_vcn.main.id
  display_name   = "rt-public"
  route_rules {
    destination       = "0.0.0.0/0"
    destination_type  = "CIDR_BLOCK"
    network_entity_id = oci_core_internet_gateway.igw.id
  }
}

resource "oci_core_route_table" "private" {
  compartment_id = var.compartment_ocid
  vcn_id         = oci_core_vcn.main.id
  display_name   = "rt-private"
  route_rules {
    destination       = "0.0.0.0/0"
    destination_type  = "CIDR_BLOCK"
    network_entity_id = oci_core_nat_gateway.nat.id
  }
  route_rules {
    destination       = data.oci_core_services.all.services[0]["cidr_block"]
    destination_type  = "SERVICE_CIDR_BLOCK"   # no es un CIDR común: lo resuelve OCI
    network_entity_id = oci_core_service_gateway.sgw.id
  }
}
El SERVICE_CIDR_BLOCK me costó entenderlo: no es un rango de IPs que escribís vos, es una
etiqueta (all-scl-services-in-oracle-services-network) que OCI traduce a las IPs de sus
servicios. Por eso se toma del data y no se escribe a mano.
El 0.0.0.0/0 de las dos tablas asusta un poco la primera vez, pero en una ruta significa
«cualquier destino que no tenga una regla más específica», o sea, la ruta por defecto. Y una ruta
no abre nada: decide por dónde sale el tráfico, no quién puede entrar. En la privada, ese
camino es el NAT, que deja salir a los nodos (a bajar imágenes, por ejemplo) pero no acepta
conexiones que empiecen desde internet. Lo que entra lo deciden las reglas de seguridad de la
sección que sigue.
NSGs: reglas por recurso, no por subnet#
OCI tiene dos formas de filtrar tráfico: las security lists, que se aplican a toda una subnet, y los network security groups (NSG), que se aplican a cada placa de red (VNIC), como los security groups de AWS. Las dos se suman: un paquete pasa si lo permite cualquiera de las dos. Casi todas mis reglas están en NSGs, porque así cada pieza tiene solo lo que necesita:
| NSG | Para qué | Reglas de entrada |
|---|---|---|
nsg-cp-endpoint |
La API de Kubernetes | 6443 desde mi IP (allowlist) · 6443 y 12250 desde la VCN, para los nodos |
nsg-workers |
Los nodos | Todo el tráfico desde la VCN · los NodePorts del load balancer desde internet |
# kubectl desde afuera, solo desde las IPs de la allowlist
resource "oci_core_network_security_group_security_rule" "cp_ext_6443" {
  for_each                  = toset(var.oke_public_endpoint_allowlist)   # ["<tu_ip>/32"]
  network_security_group_id = oci_core_network_security_group.cp_endpoint.id
  direction                 = "INGRESS"
  protocol                  = "6"   # TCP
  source                    = each.value
  source_type               = "CIDR_BLOCK"
  tcp_options {
    destination_port_range {
      min = 6443
      max = 6443
    }
  }
}
El 12250 es el puerto por el que los nodos se comunican con el control plane de OKE; está en la
lista de reglas que pide la documentación de OKE, y fue de las primeras cosas que tuve que abrir.
Los NodePorts abiertos a internet tienen una razón: el load balancer está configurado para preservar la IP real del cliente, así que los paquetes llegan a los nodos con la IP de origen de internet, no la del load balancer. Lo cuento en detalle en una próxima entrega, la de la entrada de tráfico. Como los nodos están en la subnet privada y no tienen IP pública, solo se llega a esos puertos a través del load balancer.
Security lists: una por subnet, y la default vacía#
Cada VCN trae una security list por defecto, y toda subnet que no declara
security_list_ids la usa. Trae egress abierto, algunos mensajes ICMP y el 22 (SSH) abierto a
todo internet, así que conviene no depender de ella: cada subnet declara la suya, con lo mínimo, y
la default queda vacía.
El ICMP no es tráfico de una aplicación: es el protocolo que usa la propia red para avisar
cosas, como «ese destino no existe» o «este paquete es muy grande». El ping usa ICMP, por
ejemplo. No abre ningún puerto, porque no tiene puertos: se filtra por tipo de mensaje (y a veces
por código, un subtipo), y por eso en las reglas aparece como type y code en lugar de un
número de puerto.
En la pública, lo mínimo es la salida, el ICMP y el 80/443 para los load balancers de
entrada. Los creo sin NSG propio, así que esta lista es la que los deja recibir tráfico:
resource "oci_core_security_list" "public" {
  compartment_id = var.compartment_ocid
  vcn_id         = oci_core_vcn.main.id
  display_name   = "sl-public"

  egress_security_rules {
    destination = "0.0.0.0/0"
    protocol    = "all"
  }

  # Los load balancers de entrada no tienen NSG: reciben 80/443 por acá
  dynamic "ingress_security_rules" {
    for_each = toset([80, 443])
    content {
      source   = "0.0.0.0/0"
      protocol = "6"
      tcp_options {
        min = ingress_security_rules.value
        max = ingress_security_rules.value
      }
    }
  }

  # ICMP 3/4 ("fragmentation needed"): sin esto se rompe el path MTU discovery
  ingress_security_rules {
    source   = "0.0.0.0/0"
    protocol = "1"
    icmp_options {
      type = 3
      code = 4
    }
  }
}
La de la subnet privada es igual, sin el 80/443: todo lo que necesitan los nodos ya está en
nsg-workers. El ICMP tipo 3, código 4 va en las dos a propósito. Es el mensaje con el que un
router avisa «este paquete es muy grande, mandalo más chico». Si se bloquea, las conexiones chicas
andan y las grandes se cuelgan sin error, que es de las cosas más difíciles de diagnosticar.
La default no se puede borrar, pero sí se puede tomar con Terraform y dejarla sin reglas. Así, una
subnet que se cree sin declarar su lista no hereda el 22 abierto:
resource "oci_core_default_security_list" "default" {
  manage_default_resource_id = oci_core_vcn.main.default_security_list_id
  display_name               = "sl-default-vacia"
  # sin reglas: ni entrada ni salida
}
Si la VCN ya existe y las subnets usan la default, el orden importa. Primero se suman las listas nuevas junto a la default (las reglas se suman, así que eso no corta nada). Después se saca la default de las subnets, y recién al final se vacía. Entre un paso y otro vale la pena probar que siga entrando tráfico por los load balancers y que los nodos salgan a internet y a Object Storage.
IPs públicas reservadas#
La IP del load balancer de entrada tiene que sobrevivir a que se borre y se vuelva a crear el
Service de Kubernetes; si cambia, hay que tocar el DNS. Por eso la creo reservada con
Terraform y el load balancer la toma por anotación:
resource "oci_core_public_ip" "ingress_prd" {
  compartment_id = var.compartment_ocid
  lifetime       = "RESERVED"
  display_name   = "ingress-prd-nlb"

  # La asigna el cloud controller de OKE al NLB: Terraform no tiene que pelear por eso
  lifecycle {
    ignore_changes = [private_ip_id]
  }
}
metadata:
  annotations:
    oci.oraclecloud.com/load-balancer-type: "nlb"
    oci.oraclecloud.com/reserved-ips: "<ip_reservada>"
El ignore_changes es clave: sin él, cada terraform plan quiere desasociar la IP del load
balancer, porque fue el cloud controller de OKE el que la asoció, no Terraform.
Diferencia con AWS: es el equivalente a una Elastic IP. En AWS, desde 2024, toda IPv4 pública se cobra por hora, esté en uso o no. En OCI, la IP reservada no tiene costo.
La red de los pods: flannel#
El CNI es la pieza que le da una dirección IP a cada pod y hace que los pods se encuentren entre sí. OKE ofrece dos:
- VCN-native: cada pod recibe una IP real de la subnet, como si fuera una máquina más de la red (es lo que hace el VPC CNI de EKS).
- flannel: Kubernetes arma una red propia "por arriba" de la de OCI. Los pods tienen direcciones de un rango aparte, y cuando un pod le habla a otro que está en otro nodo, flannel mete ese mensaje dentro de un paquete normal entre los dos nodos, como una carta dentro de otro sobre. La red de OCI solo ve tráfico entre nodos.
Elegí flannel:
resource "oci_containerengine_cluster" "oke" {
  # …
  cluster_pod_network_options {
    cni_type = "FLANNEL_OVERLAY"
  }
  options {
    kubernetes_network_config {
      pods_cidr     = "10.244.0.0/16"
      services_cidr = "10.96.0.0/16"
    }
  }
}
Lo que pesó en la decisión: con flannel los pods no consumen IPs de la VCN, así que no tuve que dimensionar la subnet pensando en cuántos pods entran por nodo, que con el VPC CNI de EKS es un límite real. Los rangos de pods y servicios solo tienen que no pisarse con el de la VCN.
El costo de esa decisión lo descubrí después: flannel no aplica NetworkPolicies. Kubernetes las acepta y las guarda, pero nadie las hace cumplir. Si las necesitás de verdad, se puede sumar Calico en modo policy-only encima de flannel, o elegir VCN-native desde el principio. Es una de las cosas que tengo anotadas para revisar en mi cluster.
Resumen: lo mismo en AWS y en OCI#
| Tema | AWS | OCI |
|---|---|---|
| Subnets | Por zona: una pública y una privada por AZ | Regionales: una pública y una privada para todo |
| Salida a internet | NAT Gateway por AZ, por hora y por GB | NAT Gateway sin cargo |
| Servicios del proveedor | Gateway endpoint de S3 + interface endpoints pagos | Un Service Gateway para todo, sin cargo |
| Filtrado | Security groups (y NACLs) | NSGs (y security lists) |
| IP fija de entrada | Elastic IP, con cargo por hora | IP reservada, sin cargo |
| Red de pods | VPC CNI (IPs de la VPC) | VCN-native o flannel (overlay) |
Lo que viene#
En la parte 4 va el cluster y los node pools: OKE Basic, nodos Ampere A1 repartidos en fault domains y el cluster-autoscaler.
Si te sirvió, el RSS es la mejor forma de enterarte del próximo post.